
AI 레디 데이터 표준 해설
데이터를 사용하는 주체가 사람에서 AI로 넓어지고 있습니다. 기록되지 않은 사실은 AI가 확인할 수 없습니다.
에이전트가 데이터를
추정하지 않고 활용하도록
AI 레디 데이터(AIRD) 표준은 데이터에 관한 사실을 기계가 읽는 데이터 설명서(마니페스트)에 기록하고, 품질을 측정하고, 준비 상태를 판정하고, 그 근거로 데이터를 활용하는 방법을 규정합니다. AI 에이전트는 이 기록을 근거로 판단하고, 근거가 없으면 추정하지 않고 보류합니다.
어디에 적용하나
역할별 시작점
공공데이터 · 기업 데이터를 관측한 결과는 필요성과 사례에 있습니다. 판정을 재현하려면 판정 절차, 용어와 기재 항목은 찾아보기에서 시작합니다.
사례 영상 한 편당 2분 이내
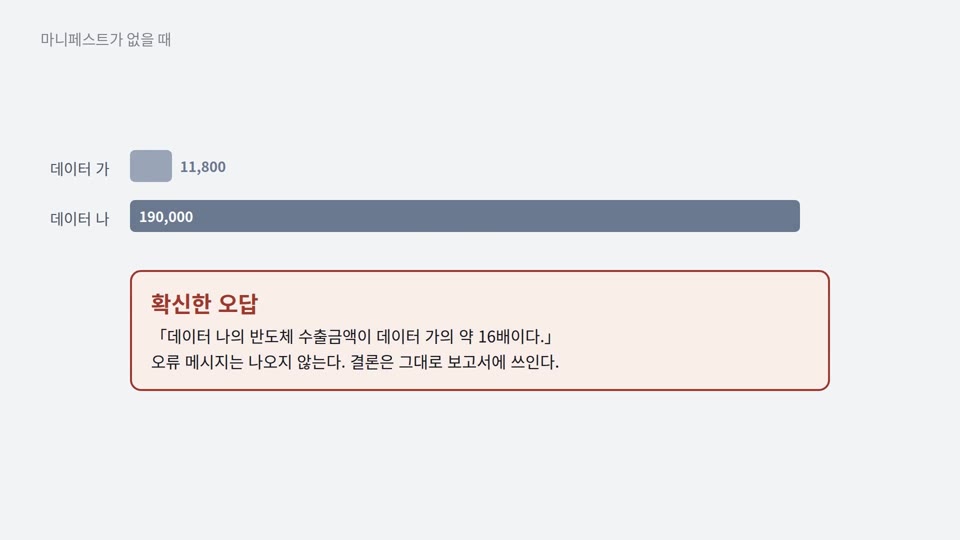 결합성 · 설명용 예시같은 이름, 다른 의미
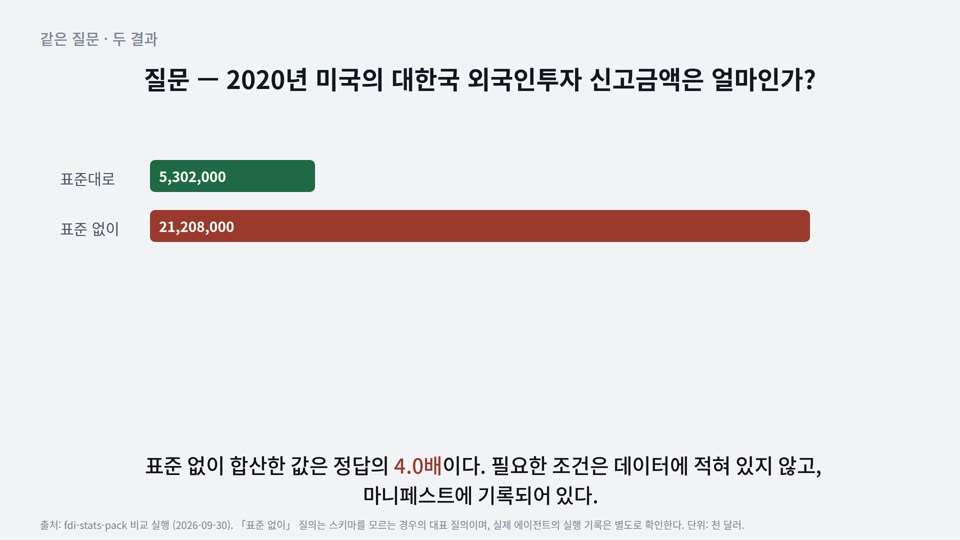 신뢰성 · 실제 데이터같은 사실의 중복 집계
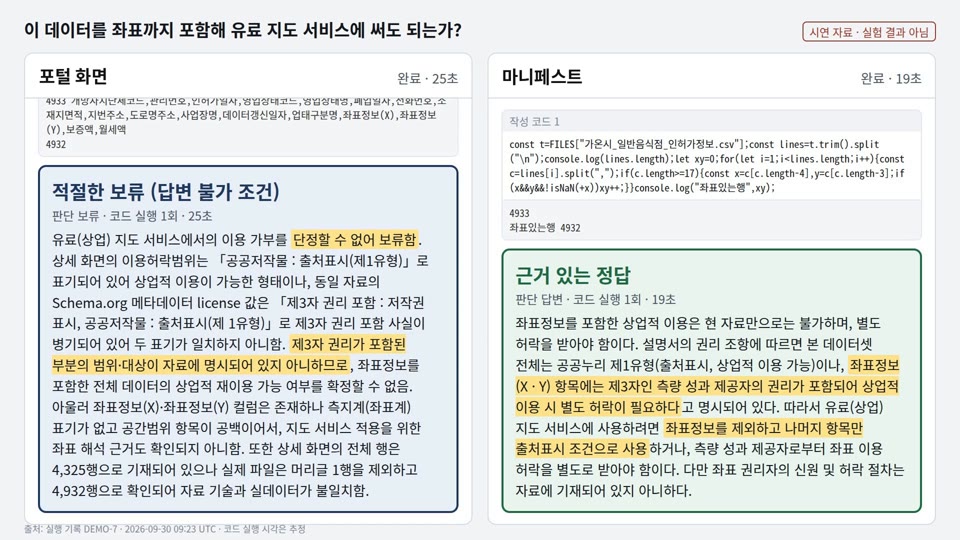 사용 가능성 · 실행 기록이용 가능 범위 판정
한눈에 보기


역할별 다음 단계
일정은 현재 상태와 공개 계획에 있습니다.
필요성과 사례
에이전트는 데이터에 기록되지 않은 사실을 추정합니다. 공개 데이터의 목록 정보만으로는 최신성·단위·이용 조건을 확인할 수 없고, 같은 모델도 기록 유무에 따라 판단 결과가 달라집니다.
공개 데이터 관측 결과
공공데이터포털 파일데이터 목록 84,271건을 관측한 결과(2026-08-31), 에이전트가 판단하지 못하게 하는 값 3가지를 확인했습니다.
- 52.2%는 업데이트 주기가 「수시」인 파일데이터의 비율입니다. 에이전트는 이 데이터가 최신인지 판정할 수 없습니다.
- 20.8%는 다음 등록 예정일이 이미 지난 파일데이터의 비율입니다. 예정이 지켜졌는지 기계가 확인할 근거가 없습니다.
- 0개는 목록개방현황 36개 항목 가운데 컬럼의 단위·코드 체계를 담는 항목의 수입니다.
기업 데이터는 자체 이용약관이 판단을 제한합니다. 확인한 3건 모두 재배포·자동 수집을 제한했습니다.
출처와 기업 데이터 관측
출처: 공공데이터포털 목록개방현황(2026-08-31, 84,271건) 관측. 포털이 내보내는 DCAT 파일 2건은 RDF 파서로 처리하지 못했습니다.
기업 데이터는 이용 조건이 먼저 걸립니다. 이용약관을 확인한 국내 민간 정형 데이터 3건은 무료로 받을 수 있었으나, 3건 모두 자체 이용약관으로 재배포·자동 수집을 제한했습니다. 어휘표의 라이선스 값 14개 가운데 자체 약관을 나타내는 값은 없습니다. 자체 약관의 내용은 이용 조건(dct:rights)에 문장으로 기재합니다. 사람은 약관을 읽고 판단하지만, 에이전트는 이용 조건을 확인할 수 없습니다.
문제의 원인
빠진 것은 데이터가 아니라 데이터를 쓰기 위한 사실입니다. 사람은 담당자에게 확인해서 보완하지만, 에이전트는 보완할 수 없습니다.
표준의 대응
표준은 이 사실들을 데이터 설명서(마니페스트)에 기계가 읽는 형식으로 기록하게 하고, 품질 측정과 판정의 근거를 남기게 합니다. 근거가 없으면 에이전트는 추정하지 않고 보류합니다. 기록·측정·판정·활용에 대한 상세 정보는 표준이 하는 일에 있습니다.
사례 영상
영상은 4개입니다(소리가 없고 자막은 기본으로 꺼져 있습니다).
시연 기록 영상은 이전 버전 규칙에 따른 실행 기록으로 제작했습니다. 에이전트의 판단은 측정 규칙과 관계없지만, 영상 속 마니페스트 형식은 지금의 어휘표와 다릅니다.
다음 단계: 표준이 하는 일
표준이 하는 일
표준은 기록·측정·판정·활용 4개 활동을 규정합니다. 개별 활동마다 기록되는 파일과 수행 주체가 다르고, 지금 수행할 수 있는 범위도 다릅니다.
4개 활동
4개 활동은 차례로 수행됩니다. 기록이 있어야 측정할 수 있고, 측정 결과와 운영 지침이 있어야 판정할 수 있으며, 에이전트는 이 기록을 근거로 판단합니다. 품질 등급은 운영 지침을 적용하는 조직이 진단 도구로 판정하며, 그 운영 지침은 표준 제공 운영 지침이거나 조직이 자체 구성해 공개한 운영 지침입니다.
| 활동 | 하는 일 | 남는 것 | 지금 |
|---|---|---|---|
| ① 기록 | 데이터의 내용·위치·이용 조건을 정해진 항목으로 기재합니다. | 데이터 설명서(마니페스트) | 지금 가능 |
| ② 측정 | 품질을 7개 차원·16개 지표로 측정합니다. | 결과서 | 진단 도구 공개 후 |
| ③ 판정 | 준비 상태와 품질 등급을 판정합니다. 기준값은 운영 지침이 설정합니다. | 준비 상태·품질 등급 | 운영 지침 적용 후 |
| ④ 활용 | 에이전트가 기록을 근거로 판단하고, 근거가 없으면 보류합니다. | 근거를 밝힌 판단 | 일부 가능 |
활동별 규정 내용·수행 주체·근거 부
| 활동 | 표준이 규정하는 것 | 남는 것 | 수행 주체 | 근거 부 | 지금 |
|---|---|---|---|---|---|
| ① 기록 데이터 설명서 작성 | 데이터의 내용·위치·이용 조건을 기재하는 항목과 형식, 버전과 체크섬의 기록 방법 | 데이터 설명서(마니페스트) | 데이터 제공 담당자 | 제3부 (공통 개념은 제1부) | 지금 가능 |
| ② 측정 품질 측정과 결과서 | 품질 7개 차원·16개 지표의 측정식, 지표 적용성 값과 측정하지 못한 사유의 기록 방법 | 결과서 | 진단 도구 (담당자는 측정에 필요한 자료를 준비) | 제2부 | 진단 도구 개발 중 |
| ③ 판정 판정 절차 | 3가지 준비 상태와 전이 조건(다음 상태로 넘어가는 조건), 측정 완성도(요구된 지표를 어디까지 측정했는지) 결정표, 품질 등급의 체계와 판정 순서. 판정 기준값(임계 프로파일)은 운영 지침이 설정 | 준비 상태·측정 완성도·품질 등급과 판정 기록 | 진단 도구·운영 지침을 적용하는 조직 | 제1부(준비 상태·전이 조건)·제2부(측정 완성도·품질 등급) | 운영 지침 적용 후 |
| ④ 활용 에이전트가 읽는 것 | 에이전트가 판단별로 읽는 항목, 근거가 없을 때의 처리, 활용 목적별 준비 | 근거를 밝힌 판단·목적별 준비 결과(운용 파일) | 에이전트·이용자·데이터 제공 담당자(목적별 준비) | 제3부(판독 항목)·제1부(활용 목적 6종) 탐색·교환·활용은 제5부후속 부 | 일부 가능 목적별 준비 절차는 목적 기준 등록 후 공개 |
판정에 사용되는 개념(준비 상태·확인 지점·측정 완성도·품질 등급)의 정확한 의미는 핵심 개념에 있습니다. 「지금」 칸의 표시는 현재 상태와 공개 계획으로 연결됩니다.
4개 활동이 공공·기업 데이터의 어디에 쓰이는지는 어디에 적용하나에 있습니다.
현재 범위와 확장
표준의 역할은 데이터를 AI가 판단할 수 있는 상태로 만들고(기록 · 측정 · 판정), 그 근거로 쓰게(활용) 하는 공통 규칙을 정하는 것입니다. 4개 활동의 현재 범위는 2026년 12월 제정 예정인 제1~3부가 정하고, 2027년 중 제정 예정인 후속 부가 같은 활동을 넓힙니다.
| 활동 | 현재 (제1~3부) | 확장 (제4·5부 · 2027년 중) |
|---|---|---|
| 기록 | 데이터 설명서의 항목과 형식 (제3부) | 변환 파이프라인 (제4부) |
| 측정 | 7개 품질 차원 · 16개 지표 (제2부) | — |
| 판정 | 준비 상태 · 품질 등급 · 확인 지점 (제1·2부) | 거버넌스 (제4부) |
| 활용 | 에이전트가 기록을 읽고 판단 (제3부 판독 항목) | 탐색 · 교환 · 활용 (제5부) |
AI 모델 · 보안 규격, 도메인 온톨로지, 거래 · 계약 · 가격, AI 윤리 · 편향 측정은 표준의 범위 밖이며, 필요하면 외부 표준과 결합합니다.
함께 제공하는 파일
데이터 파일만 제공하면 에이전트는 데이터의 의미·품질·이용 조건을 추정하게 됩니다. 따라서 AI 레디 데이터는 판단에 필요한 사실을 담은 문서를 데이터 파일과 함께 제공하며, 표준은 이 배포 단위를 팩(Pack)이라 부릅니다. 팩은 다음 파일로 구성됩니다.
- 데이터 파일: 팩에 넣지 않고 주소·SHA-256 체크섬으로 가리킵니다.
- 마니페스트: 찾는 정보·품질 근거·목적별 준비 상태를 기술하고, 나머지 파일의 주소·체크섬을 기재합니다.
- 결과서: 측정한 지표와 측정하지 못한 지표를 기록합니다.
- 팩 마니페스트: Quality-Ready 이상의 팩에 포함됩니다.
- 목적별 운용 파일: 활용 목적이 정해졌을 때 생성합니다.
에이전트는 팩의 근거를 읽고 판단하며, 근거가 없으면 보류합니다. 팩의 구성·파일 형식·검증은 팩 구성과 배포에 있습니다.
표준 문서
AI 레디 데이터 표준은 5개 부로 구성됩니다. 제1~3부가 2026년 12월 제정 범위의 표준 초안이고, 제4·5부는 2027년 중 제정 예정인 후속 부입니다. 판정 기준값은 표준과 별도의 운영 지침이 설정합니다.
부의 구성·운영 지침·메뉴와 부·인용의 구분
표준의 구성
제1부의 공통 개념을 바탕으로 제2부가 측정과 판정을, 제3부가 기록을 다룹니다. 제4부(변환 파이프라인·거버넌스)와 제5부(탐색·교환·활용)는 후속 부입니다. 제1~3부가 TTAK 초안(0.95 버전)입니다.후속 부
| 부 | 표준 명칭 | 역할 | 준거 문서 |
|---|---|---|---|
| 제1부 | AI 레디 데이터 - 제1부: 개요 및 프레임워크 | 개요와 프레임워크·용어·준비 상태·데이터 유형·활용 목적 유형 | 표준 초안 |
| 제2부 | AI 레디 데이터 - 제2부: 품질 측정·등급화 | 품질 측정·등급화·16개 지표·측정 완성도(표준 용어: 진단 성숙도, DM) | 표준 초안 |
| 제3부 | AI 레디 데이터 - 제3부: 데이터셋 기술 스키마 및 응용 프로파일 | 데이터셋 기술 스키마·마니페스트 항목 명세·응용 프로파일·통제 어휘 | 표준 초안 |
| 제4부 | AI 레디 데이터 - 제4부: 변환 파이프라인·거버넌스 | 후속 부에서 정함 | 후속 부 — 2027년 중 제정 예정 |
| 제5부 | AI 레디 데이터 - 제5부: 탐색·교환·활용 | 후속 부에서 정함 | 후속 부 — 2027년 중 제정 예정 |
제1~3부는 2026년 3월 9일에 작성을 시작했고, 2026년 5월 13일 제1~5부를 TTA에 표준으로 제안했으며, 심의는 TTA 정기 회의에서 진행 중입니다. 진행 경과는 표준의 출발과 경과에 있습니다.
스펙 문서
요건은 스펙 문서가 규정하므로, 해설과 스펙이 다르면 스펙이 우선합니다. 이 사이트는 스펙을 옮겨 싣지 않고 링크하며, 스펙 문서 주소는 표준 제정 시 연결합니다. 「근거:」 줄의 표시(예: 제2부 8.1)는 스펙의 조항입니다. 스펙 문서의 공개 시점은 현재 상태와 공개 계획에 있습니다.
운영 지침
판정 방법과 등급 체계는 표준이 규정하고, 판정 기준값(임계 프로파일)과 진단 주기·이의제기 같은 운영 사항은 운영 지침이 설정합니다. 조직·기관·도메인은 운영 지침을 독립적으로 구성할 수 있으며, 등급에는 적용한 운영 지침의 식별자·버전을 함께 기재합니다. 운영 지침의 구성과 임계 프로파일 항목은 운영 지침 구성에 있습니다.
이 사이트의 메뉴와 부
인용의 구분
스펙이 인용하는 외부 문서는 준수 의무에 포함되는 규범적 인용과 이해를 돕는 참고 문헌으로 구분합니다. 두 목록은 스펙 문서에 있습니다.
다음 단계: 어디에 적용하나
근거: 제1부 3.15, 5.5
어디에 적용하나
찾을 수 있는 데이터(Discoverable)는 데이터 카탈로그에, 품질이 확인된 데이터(Quality-Ready)는 품질 근거 공개와 데이터 검수에, 목적에 맞게 준비된 데이터(Purpose-Ready)는 검색증강생성·기계학습·통계 분석에 적용합니다. 공공·기업 데이터에 같은 절차를 사용합니다.
조직별 시작점
조직의 상황에 따라 시작하는 단계와 지금 수행할 수 있는 범위가 다릅니다.
| 상황 | 시작점 | 지금 |
|---|---|---|
| 데이터를 외부에 개방하거나 제공 | 1단계 — 목록 메타데이터를 발견 계층으로 정비 (데이터 설명서 작성) | 지금 가능 |
| 사내 AI·에이전트가 데이터를 찾아 사용 | 1단계 + 사용 가능성 항목(라이선스·이용 조건·접근 권한) 우선 (에이전트가 읽는 것) | 지금 가능 |
| 데이터를 구매·조달하거나 납품 | 2단계 — 결과서와 운영 지침 (도입 판단 요약) | 진단 도구 공개 후 |
| RAG·기계학습용으로 데이터를 가공 | 1·2단계를 먼저 수행하고 3단계 준비 | 목적 기준 등록 후 |
| 여러 조직의 데이터 품질을 순위로 비교 | 적합하지 않습니다. 등급은 적용한 운영 지침과 함께 읽어야 하므로, 서로 다른 운영 지침의 등급을 순위로 비교할 수 없습니다. | — |
찾을 수 있는 데이터 — 데이터 카탈로그
공공 분야는 공공데이터포털·기관 포털의 목록, 기업에서는 사내 데이터 카탈로그·거래소 상품 정보에 적용하며, 지금 수행할 수 있습니다.
공공·기업 적용 예
1단계는 데이터셋의 내용·위치·이용 조건을 기계가 읽는 메타데이터로 제공하는 일이며, 형식은 데이터 설명서(마니페스트)의 발견 계층 23개 항목입니다. 데이터 카탈로그에 이 표준을 적용하는 단계로, 데이터값은 바꾸지 않고 진단 도구나 운영 지침 없이 지금 수행할 수 있습니다.
| 구분 | 적용 대상 | 표준 적용 내용 |
|---|---|---|
| 공공 | 공공데이터포털·기관 개방 포털의 목록 메타데이터 | 포털 목록의 항목은 국내 데이터 포털용 응용 프로파일 DCAT-AP-KR의 어휘로 표현할 수 있습니다. 발견 계층은 이 어휘를 적용하고 에이전트의 판단에 필요한 항목(수명 주기 상태·생성 방법 등)을 추가하며, 갱신 주기 같은 값은 문자열 대신 표준 값 목록으로 기재합니다. |
| 기업 | 사내 데이터 카탈로그·데이터 거래소의 상품 등록 정보·협력사에 주는 데이터 명세 | 같은 항목과 값 목록을 사용합니다. 등록 정보의 제목·설명은 사내 카탈로그에서 가져오고, 식별자는 회사 도메인 기반 주소로 기재합니다. |
이 단계를 거치면 에이전트는 데이터를 찾고, 갱신 주기와 이용 조건을 메타데이터에서 읽고 처리할 수 있습니다. 공공데이터포털 목록 메타데이터에 표준 초안의 판정 일부를 적용한 MCP 서버(공공데이터 렌즈)가 이 단계의 실제 적용 예입니다.
품질이 확인된 데이터 — 품질 근거와 검수
공공에서는 개방 데이터의 품질 공개, 기업에서는 구매 데이터 검수에 적용하며, 진단 도구 공개 후 수행할 수 있습니다. 공통 준비 요건을 충족한 Quality-Ready 상태의 데이터는 AI 레디 데이터입니다.
공공·기업 적용 예와 현재 상태
2단계는 데이터값의 품질을 7개 차원·16개 지표로 측정하고, 측정한 지표와 측정하지 못한 지표를 결과서에 함께 기록하는 일입니다. 품질 등급은 적용한 운영 지침의 판정 기준값으로 판정합니다.
| 구분 | 적용 대상 | 표준 적용 내용 |
|---|---|---|
| 공공 | 개방 데이터의 품질 정보·여러 기관 데이터의 결합 전 점검 | 품질 점검 결과를 기계가 읽는 결과서로 공개합니다. 코드표 대조(참조 무결성)·레코드 키 유일성 같은 지표로 결합 전에 문제를 찾습니다. |
| 기업 | 구매·조달하는 데이터의 검수·사내 데이터 파이프라인의 배포 전 점검 | 납품 조건에 「운영 지침 식별자·버전과 품질 등급」을 기재할 수 있습니다. 조달·계약 문안은 검토 중입니다. |
결과서를 만들 진단 도구의 배포 버전은 개발 중입니다. 조직은 자체 운영 지침을 구성할 수 있으며, 표준 제공 운영 지침은 표준 제정 시 공개합니다. 일정은 현재 상태와 공개 계획에 있습니다.
목적에 맞게 준비된 데이터 — AI 활용 목적별 준비
공공에서는 법령 문서 검색증강생성·전력 수요 통계 분석, 기업에서는 사내 문서 검색·기계학습용 데이터처럼 활용 목적별 준비에 적용합니다. 목적 기준이 등록되면 수행할 수 있습니다.
공공·기업 적용 예와 현재 상태
3단계는 활용 목적마다 필요한 준비를 하고 목적별 운용 파일을 만드는 일입니다. 표준의 활용 목적은 기계학습(ML)·심층학습(DL)·검색증강생성(RAG)·미세조정(FineTuning)·지식그래프(KG)·통계 분석(Stats)의 6종입니다.
| 구분 | 적용 대상 | 이 사이트의 예 |
|---|---|---|
| 공공 | 법령·행정 문서 질의응답·통계 분석·지식그래프 구축 | 공공데이터 예제 — 법령 문서 × 검색증강생성·법령해석 사례 × 미세조정·전력 수요 × 통계 분석·상가(상권)정보 × 지식그래프 |
| 기업 | 사내 문서 검색(RAG)·기계학습용 데이터·상담 지시문·응답 쌍 미세조정 | — |
목적 등급은 목적 기준(목적 프로파일)이 등록되어야 판정합니다. 지금은 등록된 목적 기준이 없어 모든 예제의 목적 등급이 「판정하지 않음」이며, 목적별 준비 안내는 목적 기준이 등록되면 공개합니다.
표준의 적용 범위 밖
- 포털 기능: 데이터 포털의 기능(검색 화면·질의응답·추천)은 다루지 않습니다. 표준의 대상은 데이터와, 기계가 읽고 처리할 수 있는 데이터의 기록입니다.
- 의무 여부: 이 표준은 법령이나 규정에 따른 의무가 아닙니다. 조직이 관리 지침·사업 요구사항·계약 조건에서 인용해 사용합니다.
- 개인정보: 개인정보 판단을 대신하지 않습니다. 개인정보 포함 여부는 기록하고, 판단은 개인정보 보호 담당 부서가 합니다.
다음 단계: 현재 상태와 공개 계획
현재 상태와 공개 계획
지금은 1단계 데이터 설명서 작성과 결함 수정을 수행할 수 있습니다. 품질 등급 판정에는 운영 지침이 필요하며, 표준 제공 운영 지침은 표준 제정 시(2026년 12월 예상) 공개합니다.
지금 할 수 있는 것
Quality-Ready는 진단 도구의 측정 결과와 운영 지침이 모두 있어야 판정하므로, 지금 도달할 수 있는 최고 상태는 Discoverable입니다. 진단 도구 배포 버전이 공개되기 전에는 이 사이트의 절차만으로 Quality-Ready에 도달할 수 없습니다. 행동별 현재 상태는 다음과 같습니다.
| 행동 | 지금 | 사용할 수 있는 것·기다리는 것 |
|---|---|---|
| 데이터 설명서 작성 | 가능 | 기재 항목 · 1단계 점검표 · 카탈로그 변환기 |
| 데이터 설명서 검증 | 일부 | 점검표로 직접 확인 · 검증기는 검토 중 |
| 결함 수정·한계 기록 | 가능 | 결함 수정 |
| 품질 측정·결과서 | 대기 | 진단 도구 공개 후 (시점 미정) |
| 품질 등급 판정 | 대기 | 측정 결과 + 운영 지침. 조직이 운영 지침을 직접 구성할 수 있음 |
| 목적별 준비 | 대기 | 목적 기준 등록 후 (시점 미정) |
| 에이전트 활용 | 일부 | 공공데이터 렌즈(MCP) · 판단별 필드와 처리 |
표준의 일정
제정 전까지 이 사이트의 해설은 TTAK 초안(0.95 버전)과 「AIRD 어휘표 v0.10.5」를 기준으로 합니다.
| 시점 | 내용 |
|---|---|
| 2026-03-09 | 제1~3부 작성 시작 |
| 2026-05-13 | 제1~5부를 TTA에 표준으로 제안 · 이후 TTA 정기 회의에서 심의 중 |
| 2026년 12월 (예상) | 제1~3부 제정 · 표준 제공 운영 지침 공개 · 스펙 문서 링크 연결 |
| 2027년 중 (예정) | 제4부(변환 파이프라인·거버넌스) · 제5부(탐색·교환·활용) 제정 — 후속 부 |
사이트 공통 표시
후속 부·제안·검토 중·개발 중 같은 표시는 사이트의 모든 페이지에 적용됩니다.
표시별 뜻
| 표시·주제 | 뜻 |
|---|---|
| 후속 부 | 제4·5부를 인용한 곳입니다. 제4·5부는 2026년 12월 제정 범위(제1~3부)에 포함되지 않으며, 2027년 중 제정 예정입니다. |
| 제안 | 표준 개정안으로 제안한 속성입니다. 현행 요건이 아닙니다. |
| 검토 중 | 공개 범위와 형태를 결정하는 단계의 도구 · 자료입니다. |
| 개발 중 | 개발하는 단계의 도구 · 자료입니다. 공개 시점은 정해지지 않았습니다. |
| 측정 엔진(시험용)의 결과 | 이 사이트의 측정 엔진이 예시 파일을 계산한 값입니다. 실제 에이전트의 행동과 답의 정확도에 주는 효과는 아직 측정하지 않았습니다. |
| 적용 의무 | 법령이나 규정에 따른 의무는 아닙니다. 기관·기업은 데이터 관리 지침, 사업 요구사항, 계약 조건에서 이 표준을 관련 표준으로 인용해 활용할 수 있습니다. |
| 해설과 스펙 | 요건은 스펙 문서가 규정합니다. 해설과 스펙이 다르면 스펙이 우선합니다. |
표준의 출발과 경과
표준의 핵심 판단이 언제, 어떤 문제 인식에서 나왔는지 날짜순으로 기록했습니다. 2025년 항목은 당시 제안 자료에서 개념만 옮긴 것으로, 현재 표준이 아닙니다.
날짜순 기록
2025년 항목의 원자료는 김학래(중앙대학교 HIKE 연구실)가 작성·제안한 자료이며, 항목마다 지금 표준과 달라진 점을 「현재」로 함께 기재했습니다.
문제 정의 2025년 8월 ~ 9월
2025-08 · 표준 관리 범위가 메타데이터에 한정되고 데이터 값은 포함하지 않습니다
데이터를 3개의 계층으로 나누어 진단했습니다 — 데이터 값(Level 0), 데이터셋 메타데이터(Level 1), 서비스 수준의 데이터(Level 2). 국제 메타데이터 표준은 Level 1에 적용되어 있습니다. 데이터 값에는 표준이 없어 데이터 간 연계가 어렵다고 판단했습니다.
현재: 표준은 기록(제3부)과 데이터 값의 품질 측정(제2부)을 함께 포함하고 있습니다 — 품질 지표
2025-08 · 사람 중심 활용에서 사람과 AI의 공동 활용으로
데이터 제공에서 AI 활용까지의 준비 과정을 정제 · 구조화 · 계보 · 편향 최소화 · 통합 · 접근성의 6개의 단계로 구분하고, 준비 결과를 제공 주체의 품질관리에 환류하는 구조로 설계했습니다.
현재: 준비 단계는 데이터 설명서(마니페스트) 작성 · 품질 측정 · 목적별 준비의 3개 단계이고, 단계마다 확인 지점과 산출물이 있습니다 — 준비 개요
2025-08 · 정의와 성숙도 단계의 제안
「추가 정제 없이 AI가 학습 · 추론 · 활용할 수 있는 데이터」를 정의로, 품질 → 학습 → 생성형 AI → 추론으로 올라가는 성숙도 단계와 단계별 평가 지표 초안을 제안했습니다.
현재: 표준은 단일 성숙도 단계를 두지 않습니다. 측정 완성도 · 품질 등급 · 목적 등급을 따로 판정하고 합산하지 않습니다 — 판정 절차
2025-09 · 현재 데이터와 AI 레디 데이터의 비교
제공 형식 · 품질관리 · 품질 기준 · 이용 대상 · 포털 기능의 5개 축으로 비교했습니다.
| 축 | 2025년 당시의 「현재 데이터」 | 2025년 당시의 「AI 레디 데이터」 | 현재 |
|---|---|---|---|
| 제공 형식 | CSV · Excel · API | JSON · Parquet · RDF · API | 형식보다 마니페스트와 품질 근거 우선 |
| 품질관리 | 메타데이터와 일부 규칙 | 데이터 값 전체와 의미 품질 | 메타데이터 기록과 데이터 값 측정의 병행 |
| 품질 기준 | 명확한 지표 없음 | 정확성 · 완전성 · 일관성 지표 관리 | 측정 방법과 등급 체계는 표준이, 판정 기준값은 운영 지침이 결정 |
| 이용 대상 | 사람 중심 | 사람과 AI의 공동 활용 | 기록만으로 에이전트가 판단할 수 있는지 여부 |
| 포털 기능 | 검색 · 내려받기 위주 | 질의응답 · 추천 API 같은 AI 활용 중심 | 표준의 범위 밖 — 표준의 대상은 데이터와 그 기록 |
당시 안에 있던 수치 기준값은 옮기지 않았습니다. 표준은 수치 기준값을 규정하지 않습니다. 수치 기준값은 운영 지침의 임계 프로파일(판정 기준값)이 설정합니다.
정의의 정밀화 2025년 10월
2025-10 · 구조 · 의미 · 신뢰정보
「기계가 판독할 수 있는 구조, 표준 코드 · 관계 정보 같은 의미, 출처 · 버전 · 편향 같은 신뢰정보를 갖추어 AI가 학습 · 추론 · 생성에 직접 활용할 수 있도록 준비된 데이터」로 정의를 수정했습니다.
현재: 기재 항목과 「AIRD 어휘표 v0.10.5」의 발견 · 이해 계층으로 구체화했습니다 — 기재 항목
2025-10 · 형식 중심 품질에서 의미 · 값 중심 품질로
날짜 형식 · 결측 같은 형식 점검을 넘어 표준 코드 적용과 값의 의미를 품질의 대상에 포함하고, 국제 기준(예: ISO/IEC 5259)과 정렬할 것을 제안했습니다.
현재: 16개 품질 지표, 다른 표준과 대응 관계 — 품질 지표
표준 준비로 전환 2025년 11월
2025-11-03 · 가이드라인 항목에서 표준 어휘로
AI 활용에 직접 기여하는 항목(품질 점수 · 편향 정보 · 결측 처리 방침 · 준비 단계)을 필수로, 행정 관리 항목을 선택으로 구분하는 메타데이터 안을 제안하고, 다음 3가지를 후속 작업으로 권고했습니다.
| 2025년 11월의 권고 | 지금 표준 · 사이트 |
|---|---|
| ① 메타데이터 정의서와 검증 규칙(유효값 · 형식 검증) 정교화 | 기재 항목 · 판정 절차 |
| ② 국내외 표준 어휘(예: ISO/IEC 5259 · DCAT-AP-KR)의 적용 모델 설계 | 어휘표 v0.10.5 |
| ③ 여러 분야에 공통으로 쓰는 메타데이터 어휘 개발 | 발행 주체를 가리지 않는 범위 · 한눈에 보기 |
표준화와 공개 도구 2025년 11월 이후
2026-03-09 · AI 레디 데이터 표준 초안 제1~3부 작성 시작
「AI 레디 데이터 - 제1부: 개요 및 프레임워크」 · 「제2부: 품질 측정·등급화」 · 「제3부: 데이터셋 기술 스키마 및 응용 프로파일」의 작성을 시작했습니다. 변환 파이프라인·거버넌스(제4부)와 탐색·교환·활용(제5부)은 후속 부로 이어집니다.
현재: TTAK 초안(0.95 버전), 2026년 12월 제정 범위 — 표준이 하는 일
2026-04-14 · 표준 개발 도구의 공개
표준을 개발하면서 구현 도구 모음(aird-tools)을 공개 저장소에 게시했습니다.
현재: 사용 가능한 도구와 상태 — 공개 도구
2026-05-13 · TTA 표준 제안
제1~5부를 TTA에 표준으로 제안했습니다. 심의는 이후 TTA 정기 회의에서 진행 중입니다.
현재: 심의 중 — 표준이 하는 일
2026-08-03 · 표준 초안을 적용한 MCP 서버
공공데이터포털 목록 메타데이터에 표준 초안의 판정 일부를 버전 관리되는 규칙으로 적용한 MCP 서버(공공데이터 렌즈)를 공개했습니다.
현재: 사용 가능한 도구와 상태 — 공개 도구
2026-09-30 · AIRD 어휘표 v0.10.5
기재 항목의 이름 · 값 범위 · 필수 여부를 어휘표로 고정했습니다.
현재: 이 사이트의 기준 어휘 — 기재 항목
2026-10 · 발행 주체를 가리지 않습니다
표준의 대상과 수요처를 공공데이터로 한정하지 않는다는 방침을 사이트 전체에 반영했습니다. 2025년 11월 권고 ③(분야 공통 어휘)의 방향입니다.
현재: 공공기관 · 기업 · 민간 비영리의 데이터를 같은 절차로 다룹니다 — 한눈에 보기
다음 단계: 준비 개요
데이터 준비 › 절차
준비 개요
보유 데이터를 AI가 활용할 수 있는 상태로 만드는 절차는 데이터 확인과 3개 단계로 구성됩니다. 데이터 확인과 1단계는 지금 담당자가 단독으로 수행할 수 있고, 2단계부터는 진단 도구와 운영 지침이 필요합니다.
단계와 산출물
각 단계의 끝에는 확인 지점이 있으며, 확인 지점을 통과하면 데이터의 준비 상태가 한 단계 올라갑니다. 통과하지 못한 항목은 탈락이 아니라 보완 대상이므로, 보완한 뒤 다시 확인합니다. 표준에서 AI 레디 데이터는 AI 활용을 위한 공통 준비 요건을 충족한 Quality-Ready 또는 Purpose-Ready 상태의 데이터를 뜻합니다.
| 단계 | 하는 일 | 산출물 | 도달 상태 |
|---|---|---|---|
| 데이터 확인 | 유형·인코딩·개인정보 확인 | 확인 기록 | — |
| 1단계 데이터 설명서 작성 | 기재 항목·컬럼 정의서·고유 식별자 작성 | 데이터 설명서 manifest.json | Discoverable |
| 2단계 품질 측정·결함 수정 | 지표 측정·값 수정·한계 기록 | 결과서·정제본·처리 이력 | Quality-Ready |
| 3단계 목적별 준비 | 활용 목적별 운용 파일 작성 | 목적별 운용 파일 | Purpose-Ready |
원본은 정제본과 함께 보존하고, 단계는 순서대로 진행합니다. 단계별로 나누어 수행할 수 있으며, 1단계만 마쳐도 에이전트가 추정해야 하는 항목이 줄어듭니다. Quality-Ready 이상으로 판정된 데이터는 팩으로 배포하고, 그 전에는 데이터 설명서를 공개합니다.
단계별 판정 조건과 산출물 형식
| 도달 상태 | 판정에 필요한 것 | 산출물 형식 |
|---|---|---|
| Discoverable | 발견 계층 필수 기재 항목 충족 | manifest.json(JSON-LD) — 발견 계층과 컬럼 정의서 |
| Quality-Ready | 측정 완성도 DM-2, 운영 지침의 임계 프로파일로 판정한 품질 등급 Tier 1 이상 | 결과서(JSON)·정제본·처리 이력·한계 기록, 데이터 설명서의 이해 계층 |
| Purpose-Ready | 목적 프로파일 등록, 운용 계층 필수 항목 충족 | 목적 유형마다 운용 파일 1개 |
데이터 설명서는 버전마다 새로 발행하고 이전 버전을 가리킵니다. 팩은 데이터 설명서·결과서·팩 마니페스트·운용 파일로 구성하며, 데이터 파일은 주소와 체크섬으로 참조합니다. 등급 판정 절차는 판정 절차에 있습니다.
준비 전후 비교
1단계는 값의 내용을 변경하지 않고, 값의 의미·형식·출처를 설명하는 정보를 추가합니다. 2단계의 결함 수정은 값을 변경할 수 있으며, 수정 대상·방법·사유를 처리 이력에 기록합니다.
| 항목 | 준비 전 | 준비 후 |
|---|---|---|
| 컬럼 의미 | 컬럼명만 있음 | 이름·자료형·설명·코드값 |
| 갱신 주기 | 「수시」 | 표준 목록의 URI (예: …/frequency/IRREG) |
| 이용 조건 | 「제3자 권리 포함 여부 N」 | 어휘표 라이선스 값 (예: KOGL-1) |
| 파일 정보 | 없음 | 접근 주소·미디어 타입·파일 형식·체크섬 |
| 품질 | 알 수 없음 | 7개 차원 점수, 측정 완성도, 근거 |
| 한계 | 없음 | 치우침·부적합 용도·결측 원인 |
| 이력 | 없음 | 수정 내용·일자·사유 |
지금 할 수 있는 범위
데이터 확인과 1단계의 데이터 설명서 작성, 체크섬 계산은 담당자가 단독으로 수행할 수 있습니다. 고유 식별자는 조직의 식별자 정책을 확인한 뒤 결정합니다.
2단계의 품질 측정과 결과서 작성에는 진단 도구가 필요하며, 진단 도구의 배포 버전은 개발 중입니다. 품질 등급 판정에는 운영 지침이 필요합니다. 표준 제공 운영 지침은 표준 제정 시(2026년 12월 예상) 공개되며, 조직은 자체 운영 지침을 구성해 판정할 수도 있습니다. 따라서 현재 담당자가 도달할 수 있는 준비 상태는 Discoverable입니다. 일정은 현재 상태와 공개 계획에 있습니다.
표 형태(STRUCT)와 시계열(TSERIES) 데이터는 실행 항목까지 안내합니다. 문서·이미지·지시문·응답 쌍 데이터도 절차는 같으며, 유형별 추가 항목은 이후 버전에서 보완합니다.
시작 단계 결정
이미 개방 중인 데이터는 다음 5개 문항으로 시작 단계를 결정합니다. 가장 앞의 「아니오」가 시작 단계를 결정하며, 뒤 문항의 「예」는 앞 문항이 충족된 뒤에만 유효합니다. 5개 문항은 기존 등록 정보를 기준으로 하므로, 데이터 설명서(manifest.json)가 아직 없으면 모두 「예」여도 1단계부터 시작합니다.
문항과 시작 단계
- 데이터를 CSV·JSON 등 개방 형식으로 제공합니까?
- 컬럼별 의미를 기재한 문서(컬럼 정의서)가 있습니까?
- 데이터의 기준 시점과 갱신 주기를 명시했습니까?
- 이용 조건을 확인 가능한 형태로 기재했습니까?
- 데이터의 결측값과 한계를 기록했습니까?
| 가장 앞의 「아니오」 | 시작 단계 |
|---|---|
| 1번 또는 2번 | 데이터 설명서 작성(1단계) — 개방 형식과 컬럼 설명이 없으면 품질 측정이 성립하지 않음 |
| 3번 또는 4번 | 1단계의 기재 항목 작성 |
| 5번 | 품질 측정(2단계) — 한계 기록은 2단계 작업 |
| 없음 (모두 「예」) | 데이터 설명서(manifest.json)가 있으면 품질 측정(2단계), 없으면 데이터 설명서 작성(1단계) |
「아니오」 응답은 담당자의 오류를 의미하지 않습니다. 기존 포털 등록 화면에는 기재 항목 23개 중 입력란이 없는 항목이 있었고, 기계 판독 형식의 제공도 지원하지 않았습니다.
시작 전 준비 자료
작업을 시작하기 전에 데이터 파일, 현재 등록 정보, 컬럼 설명, 실제 갱신 이력, 이용 조건을 준비합니다. 자료가 부족하면 작성할 수 있는 기재 항목부터 작성합니다.
자료별 확인 위치
| 자료 | 확인 위치 | 없는 경우 |
|---|---|---|
| 데이터 파일 | 담당 시스템·포털 등록분·사내 데이터 카탈로그 | 1단계의 기재 작업부터 시작 |
| 현재 등록 정보 | 공공데이터는 포털 등록 화면, 기업 데이터는 사내 카탈로그 또는 거래소 상품 등록 정보 | 새로 작성 |
| 컬럼 설명 | 원본 데이터베이스의 컬럼 주석 | 1단계에서 작성 |
| 갱신 주기 | 실제 갱신 이력 | 실제 주기를 먼저 확인 |
| 이용 조건 | 공공데이터는 기관의 개방 정책, 기업 데이터는 이용약관·라이선스 문서(시행일 포함) | 담당 부서에 확인 |
이 사이트의 요건 표시
| 표시 | 의미 |
|---|---|
| 필수 | 현행 표준 초안이 필수로 규정한 사항 |
| 기준 | 운영 지침(임계 프로파일)이 설정하는 사항 |
| 권고 | 이 사이트가 작업 편의를 위해 권하는 사항으로, 표준 초안의 요건이 아님 |
| 예시 | 설명을 위한 값이나 문장 |
데이터 준비 메뉴는 이 표시를 문장으로 풀어서 사용합니다. 「반드시」는 필수, 「권고합니다」는 권고에 해당합니다. 「권장」은 어휘표가 정한 기재 등급(필수·권장·선택)에만 씁니다.
완료 확인
- 시작 단계(1단계 또는 2단계) 결정
- 준비 자료 5종의 확보 여부 확인
다음 단계: 데이터 확인
근거: 제1부 3.1, 3.15, 5.1, 5.2, 5.5 · 제3부 5.1
데이터 준비 › 절차
데이터 확인
1단계를 시작하기 전에 데이터 유형, 문자 인코딩의 UTF-8 준수 여부, 개인정보 포함 여부를 확인합니다. 예상 소요 시간은 약 10분입니다.
1. 데이터 유형 결정
데이터 유형에 따라 측정 지표와 데이터 설명서의 기재 항목이 달라지므로 유형을 먼저 결정합니다. 대부분의 행정·업무 데이터는 행과 열로 구성된 표 형태(STRUCT)입니다. 센서 측정값이나 일별 가격처럼 시간 순서로 누적된 표는 시계열(TSERIES)로 선택하고, 기준 시점·측정 주기·단위를 함께 기재할 것을 권고합니다.
| 데이터 예시 | 유형 |
|---|---|
| 사업장 등록 현황, 인허가 목록, 거래 내역 | 표 형태 STRUCT |
| 설비 센서 측정값, 일별 가격 | 시계열 TSERIES |
| 민원 답변, 고시 원문, 보고서 | 문서 TEXT |
| 시설물 점검 사진, 위성 영상 | 이미지 IMAGE |
| 상담 질문–답변 쌍 | 지시문·응답 쌍 PT |
하나의 파일에 여러 유형이 혼합되어 있으면 대표 유형 하나를 선택하고, 나머지 유형의 확인 항목도 함께 점검합니다. 결정한 유형은 2단계에서 결과서와 데이터 설명서의 데이터 유형(aird:dataType)에 기재됩니다.
유형별 측정 지표 수
유형마다 반드시 측정하는 지표(정식 필수 지표)의 수가 다릅니다. 16개 품질 지표 가운데 STRUCT 13종, TSERIES 13종, TEXT 5종, PT 8종, IMAGE 3종입니다. 정식 필수 지표를 모두 측정해야 측정 완성도가 DM-2가 됩니다.
어느 유형이든 최소한 측정하는 지표(최소 측정 지표, MMI)는 4종입니다. D5-03(통계적 타당성), D6-01(유일성), D7-01(인코딩 일관성), D7-02(기술적 유효성) 가운데 그 유형에 적용되는 지표만 측정합니다.
대조할 기준 자료가 없으면 정확성 지표는 「정확성 미측정」으로 남습니다. 이것은 감점이 아니라 측정 상태를 의미합니다. 다만 정확성 지표가 그 유형의 정식 필수 지표이면 측정 완성도가 DM-2에 이르지 못하므로, 기준 자료를 확보해야 Quality-Ready로 전이할 수 있습니다.
지표별 정의는 품질 지표, 측정 완성도의 결정 규칙은 판정 절차에 있습니다. 문서·이미지·지시문·응답 쌍의 실행 항목은 이후 버전에 수록합니다.
2. 인코딩 확인
기준 인코딩은 UTF-8입니다. CP949나 EUC-KR로 저장된 파일은 미준수로 판정되므로, 이 단계에서 UTF-8로 변환합니다.
- 확인: 터미널에서
file -i 파일명을 실행합니다. macOS에서는file -I 파일명을 사용합니다. 결과가charset=utf-8또는us-ascii이면 변환하지 않습니다. - 변환: 편집기에서 UTF-8로 다시 저장하거나 다음 명령을 실행합니다.
iconv -f CP949 -t UTF-8 원본 > 변환본
BOM이나 줄바꿈 문자는 별도로 조정할 필요가 없습니다. 조직이 다른 인코딩 기준을 정한 경우에는 그 기준을 따르고, 적용한 기준을 데이터 설명서에 기재합니다.
3. 개인정보 확인
개인정보나 가명정보가 없으면 1단계로 진행합니다. 포함되어 있으면 담당자가 단독으로 판단하지 않고, 개인정보 보호 책임자·담당 부서와 함께 다음 사항을 확인합니다.
- 처리 목적과 법적 근거
- 접근 권한 범위
- 적용한 안전조치
- 공개 가능 여부
가명처리의 완료가 공개 가능 여부를 의미하지는 않으며, 공개가 제한된다는 사실이 준비 불가를 의미하지도 않습니다. 이 절차는 공개 제공 데이터를 대상으로 하며, 공개가 제한되는 데이터를 통제된 환경에서 준비할 수 있는지는 조직이 별도로 판단합니다.
개인정보를 포함한 데이터셋은 1단계 데이터 설명서에 비식별화 수준(aird:deidentificationLevel)을 반드시 기재합니다. 개인정보 포함 여부(aird:containsPersonalData)와 처리 방법·일시는 2단계에서 이해 계층에 기재합니다.
참고: 개인정보보호위원회 「가명정보 처리 가이드라인」(2026.3.). 공공기관은 「공공 AX 프라이버시 안내서」(2026.7.)도 확인합니다.
완료 확인
- 데이터 유형 결정 및 확인 기록 작성
- UTF-8 준수 여부 확인 및 필요 시 변환
- 개인정보 포함 여부 확인
다음 단계: 데이터 설명서 작성(1단계)
근거: 제1부 5.6 표 5-5 · 제2부 7.4, 8.1, 8.2, 부속서 A.1, A.2, A.4 · 제3부 부속서 A.1
데이터 준비 › 절차
데이터 설명서 작성 (1단계)
데이터 설명서(마니페스트)는 데이터가 무엇이고 어디에 있으며 어떤 조건으로 이용할 수 있는지를 기계가 읽을 수 있는 JSON-LD 형식으로 기록한 파일입니다. 1단계에서는 기재 항목과 컬럼 정의서를 작성해 manifest.json을 만들며, 이 파일이 데이터가 Discoverable 상태에 이르는 근거가 됩니다.
1. 기재 항목 작성
기재 항목은 데이터셋 항목 19개와 배포 파일마다 기재하는 배포 자원 항목 4개, 합계 23개입니다. 공공데이터는 23개를 모두 기재합니다. 공공데이터가 아닌 경우 주제 분류와 랜딩 페이지는 권장 항목이므로 필수 항목은 21개입니다. 파일이 여러 개이면 배포 자원 항목 4개를 파일마다 기재합니다. 개인정보를 포함한 데이터셋은 비식별화 수준(aird:deidentificationLevel)을 함께 기재합니다(조건부 필수).
갱신 주기·라이선스·언어처럼 값 목록이 정해진 항목은 자유 문자열 대신 목록의 값으로 기재합니다. 라이선스·이용 조건·개인정보 공개 범위와 식별자 발급 정책은 조직이 결정하므로 담당 부서에 확인합니다.
1단계 점검표 — 23개 항목 체크
1단계 점검표 — 기재 항목 23개 (데모 프로파일)
0 / 23 채움
데이터셋
배포 자원 (파일별)
체크 상태는 이 브라우저에만 저장됩니다. 원천: 어휘표 v0.10.5 데모 프로파일.
값 목록 (주요 항목)
| 항목 | 기재하는 값 |
|---|---|
라이프사이클 상태 aird:lifecycleStatus | Discoverable · Quality-Ready · Purpose-Ready · Stale — 1단계에서는 Discoverable |
생성 방법 aird:creationMethod | collected 수집 · processed 가공 · synthetic 합성 · augmented 증강 |
갱신 주기 dct:accrualPeriodicity | ANNUAL 연 1회 · QUARTERLY 분기 · MONTHLY 월 1회 · DAILY 매일 · IRREG 수시·비정기 등 (EU Frequency 목록) |
라이선스 dct:license | KOGL-0~KOGL-4 · KOGL-AI · NO-RESTRICTION · CC-BY-4.0 등 CC 6종 · CC0-1.0 (어휘표 kr-license 14값) |
접근 권한 dct:accessRights | PUBLIC 공개 · RESTRICTED 제한 · NON_PUBLIC 비공개 |
언어 dct:language | KOR 한국어 · ENG 영어 등 (EU Language 목록) |
미디어 타입 dcat:mediaType | text/csv · application/json · image/jpeg 등 (IANA) |
데이터 설명서에는 값의 개념 URI를 기재합니다. 예를 들어 갱신 주기 ANNUAL은 http://publications.europa.eu/resource/authority/frequency/ANNUAL로 기재합니다. 데이터 서비스 유형·데이터셋 구조 유형·주제 분류의 값과 전체 개념 URI는 기재 항목에 있습니다. 기업의 자체 이용약관처럼 라이선스 목록에 없는 경우에는 이용 조건(dct:rights)에 약관 이름과 시행일을 기재합니다.
자주 누락되거나 잘못 기재되는 항목
| 항목 | 기재 기준 | 자주 나오는 오류 |
|---|---|---|
| 고유 식별자 | 변경하지 않는 영구 식별값. 해석 가능한 URI가 원칙이며 접근 주소와 다른 값 | 조직 내부 번호를 그대로 사용 |
| 키워드 | 3개 이상 | 1~2개만 기재 |
| 갱신 주기 | 표준 목록의 URI | 「분기」·「수시」 같은 자유 문자열 |
| 라이선스 | kr-license 14값에서 선택 | 「제3자 권리 포함 여부: N」 같은 문장 |
| 미디어 타입 | text/csv 형태의 IANA 표기 | 「텍스트」·「이미지」 |
| 체크섬 | 배포 파일마다 SHA-256 값 | 기재 누락 |
| 접근 주소 | 이 데이터의 실제 파일 위치 | 다른 데이터의 설명서를 복사한 뒤 주소를 수정하지 않음 — 형식 검사로는 검출되지 않음 |
이 사이트의 23개는 어휘표 v0.10.5 데모 프로파일 기준입니다. 표준 초안의 필수 항목은 19개(데이터셋 15, 배포 자원 4)이며, 데모 프로파일은 데이터셋 구조 유형·주제 분류·랜딩 페이지·관리 부서 4개를 추가했습니다.
2. 데이터 설명서 작성
작성한 기재 항목을 JSON-LD 형식으로 기록합니다. 아래 뼈대의 <…> 부분을 자기 데이터의 값으로 바꾸어 manifest.json으로 저장합니다. 진단 도구가 공개되면 도구가 생성한 초안을 수정해 사용할 수도 있습니다.
manifest.json 뼈대 (기재 항목 23개)
{
  "@context": "https://datahub.kr/ns/aird-context-3.0.jsonld",
  "@id": "<데이터셋 식별자>/manifest/1.0.0",
  "@type": "dcat:Dataset",
  "dct:identifier": "<데이터셋 식별자 — 고유 식별자 결정 참조>",
  "dct:title": "<제목>",
  "dct:description": "<설명>",
  "dcat:version": "1.0.0",
  "dcat:keyword": ["<키워드1>", "<키워드2>", "<키워드3>"],
  "dct:type": [
    "http://vocab.datahub.kr/def/dcat-ap-kr/service-type/FILE",
    "http://vocab.datahub.kr/def/aird/dataset-type/Structured"
  ],
  "dct:language": ["http://publications.europa.eu/resource/authority/language/KOR"],
  "aird:lifecycleStatus": "http://vocab.datahub.kr/def/aird/lifecycle-status/Discoverable",
  "dcat:theme": ["http://vocab.datahub.kr/def/dcat-ap-kr/data-theme/<주제>"],
  "dcat:landingPage": "<데이터 상세 페이지 URL>",
  "dct:creator": ["<생산 주체 URI 또는 조직명>"],
  "dct:publisher": "<제공 주체 URI 또는 조직명>",
  "dcatkr:maintainer": { "@type": "foaf:Agent", "foaf:name": "<관리 부서>" },
  "dcat:contactPoint": { "@type": "vcard:Contact", "vcard:fn": "<이름>", "vcard:hasEmail": "mailto:<이메일>" },
  "aird:creationMethod": "http://vocab.datahub.kr/def/aird/creation-method/collected",
  "dct:accrualPeriodicity": "http://publications.europa.eu/resource/authority/frequency/ANNUAL",
  "dct:license": "http://vocab.datahub.kr/def/dcat-ap-kr/license/KOGL-1",
  "dct:rights": "<이용 범위 고지문>",
  "dct:accessRights": "http://publications.europa.eu/resource/authority/access-right/PUBLIC",
  "csvw:tableSchema": {
    "columns": [
      { "name": "<컬럼명>", "datatype": "string", "dc:description": "<설명>", "required": true },
      { "name": "<수치 컬럼>", "datatype": { "base": "integer", "minimum": 0, "maximum": 100000 }, "dc:description": "<설명과 단위>" },
      { "name": "<코드 컬럼>", "datatype": "string", "dc:description": "<코드표 이름과 판>. 01=운영, 02=휴업, 03=폐업" }
    ],
    "primaryKey": "<레코드 키 컬럼>"
  },
  "dcat:distribution": [{
    "@type": "dcat:Distribution",
    "dcat:accessURL": "<파일 주소>",
    "dcat:mediaType": "text/csv",
    "dct:format": "http://publications.europa.eu/resource/authority/file-type/CSV",
    "spdx:checksum": { "spdx:algorithm": "SHA-256", "spdx:checksumValue": "<SHA-256 값>" }
  }]
}
- 체크섬: Linux에서는
sha256sum 파일명, macOS에서는shasum -a 256 파일명으로 계산합니다. - 문법 확인:
python3 -m json.tool manifest.json을 실행해 오류가 없는지 확인합니다. 데이터 설명서 검증기는 검토 중이므로, 기재 항목의 충족 여부는 1절의 「1단계 점검표」를 펼쳐 확인합니다.
작성한 데이터 설명서는 이용자와 에이전트가 내려받을 수 있는 공개 주소에 두고, 공공데이터는 포털 상세 화면(랜딩 페이지)에서 연결합니다. 1단계 확인 지점(G1)의 충족 여부는 지금은 점검표로 직접 확인하며, G1 판정 기록은 진단 도구가 작성합니다. 값을 채운 전체 예시는 마니페스트 예시에 있습니다. 데이터 설명서는 버전마다 새로 발행하며, 새 버전은 dcat:previousVersion으로 이전 버전을 가리킵니다.
3. 컬럼 정의서 작성
표 형태 데이터는 컬럼 정의서(csvw:tableSchema)를 반드시 작성합니다. 원본 데이터베이스의 컬럼 설명은 CSV로 내보낼 때 사라지는 경우가 많고, mkt_nm 같은 컬럼명만으로는 값의 의미를 확인할 수 없기 때문입니다. 컬럼마다 이름·자료형·설명·필수 여부를 기재하고, 코드값이 있으면 각 값의 의미도 기재합니다.
값 범위·필드 간 관계·파생 규칙·코드표와 그 판은 이 사이트의 권고 항목이지만 2단계 측정의 입력이 됩니다. 이 정보가 없으면 진단 도구는 해당 지표를 측정하지 못하고 결과서에 미측정 사유를 기록합니다. 값 범위는 설명 문장이 아니라 뼈대의 수치 컬럼처럼 자료형의 최소값·최대값(minimum·maximum)으로 기재해야 측정에 사용됩니다. 코드값의 의미는 현재 전용 속성이 없으므로 컬럼 설명에 기재하고, 같은 행으로 볼 기준 컬럼(레코드 키)은 primaryKey에 기재합니다. 컬럼 정의서는 별도 문서로 두고 데이터 설명서가 주소와 해시로 가리키게 할 수도 있습니다.
컬럼별 기재 항목과 관련 지표
| 항목 | 구분 | 예 | 측정에 쓰는 지표 |
|---|---|---|---|
| 이름(컬럼명) | 필수 | bizr_no | — |
| 자료형 | 필수 | 문자열 | — |
| 설명 | 필수 | 국세청이 부여한 사업자 등록 번호. 하이픈 없음 | — |
| 필수 여부 | 필수 | 필수 (값이 비면 안 됨) | D1-01 필수 필드 충족도 |
| 값 범위 | 권고 | employeeCount 0 이상 100000 이하 | D5-02 수치 범위 유효성 |
| 필드 간 관계 | 권고 | 폐업 여부가 1이면 폐업일이 있음 | D2-01 필드 간 관계 일관성 |
| 파생 규칙 | 권고 | 합계 = 남성 수 + 여성 수 | D2-03 파생값 정확성 |
| 코드표와 그 판 | 권고 | 한국표준산업분류(개정 차수 명시), 01=운영 · 02=휴업 · 03=폐업 | D2-02 참조 무결성 |
| 표시 이름 · 단위 | 권고 | 사업자등록번호 · 원 · ㎡ · ℃ | — |
| 빈 값 표기 | 권고 | 빈칸 | — |
빈 값 표기는 표준의 요건은 아니지만 하나로 통일합니다. 빈칸·-·N/A·0을 혼용하면 0이 실제 값인지 빈 값인지 구별할 수 없습니다.
4. 파일 형식 정리
특정 프로그램에서만 열리는 형식은 개방 형식으로 변환합니다. 표 형태는 CSV(UTF-8)를 권고하며, 대용량이면 Parquet를 함께 제공합니다. 셀 병합·소계 행·여러 줄 머리글은 제거하고, 여러 표를 시트로 나눠 담은 파일은 표마다 파일을 분리합니다. 형식 변환과 표 구조 정리는 값을 담는 형식만 바꾸며, 값의 내용은 변경하지 않습니다.
데이터 형태별 권고 형식
| 데이터 형태 | 권고 형식 | 이유 |
|---|---|---|
| 표 형태 | CSV (UTF-8) | 범용 도구에서 판독 가능 |
| 표 형태 · 대용량 | Parquet 병행 | 내려받기·처리 속도 향상 |
| 계층 구조가 있는 데이터 | JSON | 표로 평탄화하면 계층 관계 손실 |
| 지리 정보 | GeoJSON | 좌표계 포함 |
| 문서 | 원문 형식 + 텍스트 추출본 | 원문만으로는 기계 판독 불가 |
| 이미지 | 표준 이미지 형식 | 전용 형식은 범용 도구에서 판독 불가 |
이미지 라벨(정답지), 학습·검증 분할, 지시문·응답 쌍의 대응 관계, 문서 분할 단위는 1단계의 요건이 아닙니다. 라벨이 없는 사진도 Discoverable이 될 수 있습니다.
완료 확인
- 기재 항목 작성 (공공데이터 23개, 그 밖의 데이터 21개 이상)
- 컬럼마다 이름·자료형·설명·필수 여부 기재
- 배포 파일마다 체크섬 기재
manifest.json문법 확인
다음 단계: 고유 식별자 결정 — 데이터셋 식별자 항목의 값을 정합니다.
근거: 제1부 5.2 · 제3부 5.1, 부속서 A.1, A.2 · 어휘표 v0.10.5 데모 프로파일
데이터 준비 › 절차
고유 식별자 결정
데이터셋 식별자(dct:identifier)는 데이터셋을 가리키는 영구 식별값으로, 한 번 정하면 변경하지 않습니다. 조직의 식별자 발급 정책을 먼저 확인하고, 정책이 없으면 이 페이지의 잠정 규칙에 따라 URI를 결정합니다.
1. 결정 방법 확인
조직에 발급 정책이 있으면 그 정책을 적용합니다. 정책이 없고 조직이 통제하는 도메인이 있으면 그 도메인 아래에 고정 경로를 지정하고, 도메인도 없으면 상위 조직이나 공통 네임스페이스를 사용할 수 있는지 확인합니다.
| 상황 | 결정 |
|---|---|
| 조직 발급 정책 있음 | 조직 정책 적용 (잠정 규칙보다 우선) |
| 정책 없음 · 조직 도메인 있음 | https://data.<조직 도메인>/id/dataset/<이름> |
| 정책 · 도메인 없음 | 상위 조직(상위기관·그룹사) 또는 공통 네임스페이스 사용 여부 확인 |
| 모두 없음 | 유일성이 보장되는 식별자를 부여하고, 해석되지 않는다는 사실을 한계로 기재 |
식별자는 비워 두지 않습니다. 식별자가 없으면 1단계 확인 지점을 통과할 수 없습니다.
2. 식별자 작성
식별자는 조직이 통제하는 고정 네임스페이스와 데이터셋 이름으로 구성합니다. 버전·연도·파일 형식·담당 부서명처럼 시간이 지나면 변하는 요소는 넣지 않으며, 이러한 정보는 각각 버전(dcat:version), 시간 범위, 파일 형식(dct:format) 항목에 기재합니다. 데이터셋 이름에는 의미 없는 일련번호도 사용할 수 있습니다.
https://data.example.go.kr/id/dataset/biz-registry
└──────── 네임스페이스 ────────┘└ 데이터셋 이름 ┘
포털 목록키와 포털 상세 화면 주소는 재등록하면 달라지므로 식별자로 사용하지 않습니다. 포털 상세 화면 주소는 랜딩 페이지(dcat:landingPage)에, 파일을 내려받는 주소는 접근 주소(dcat:accessURL)에 기재합니다. 고유 식별자·랜딩 페이지·접근 주소는 서로 다른 값입니다.
적합·부적합 예시
| 판단 | 값 | 사유 |
|---|---|---|
| 적합 | https://data.example.go.kr/id/dataset/biz-registry | 네임스페이스 고정 · 이름 불변 |
| 적합 | https://data.example.go.kr/id/dataset/d-00417 | 의미 없는 일련번호 |
| 적합 | https://data.example.com/id/dataset/sales-daily | 기업 도메인 아래 고정 경로 |
| 부적합 | https://data.example.go.kr/file/biz_2025_v3.csv | 연도·버전·형식 포함. 접근 주소에 기재할 값 |
| 부적합 | BIZ-2025-001 | URI 아님 · 연도 포함 |
| 부적합 | 15029008 | 포털 목록키 · 재등록 시 변경 |
| 부적합 | https://www.data.go.kr/data/15029008/fileData.do | 포털 상세 화면 주소. 랜딩 페이지에 기재할 값 |
| 부적합 | https://market.example.com/products/48213 | 거래소 상품 페이지 주소. 랜딩 페이지에 기재할 값 |
3. 식별자 유지
식별자를 변경하면 그 데이터를 가리키던 모든 참조가 끊어지므로, 값을 정제하거나 새 버전을 발행하거나 파일 형식을 추가해도 식별자는 유지합니다. 포털 재등록이나 이관 시에는 랜딩 페이지와 접근 주소만 갱신합니다. 목적별 운용 파일도 원본 데이터셋의 식별자를 사용합니다. 데이터셋을 통합하거나 분할한 경우에만 다른 데이터셋으로 보고 새 식별자를 부여합니다.
정책 수립을 요청할 때 전달할 사항
- 조직이 통제하는 도메인의 유무 — 네임스페이스 결정
- 도메인 유지 기간의 보장 여부 — 식별자 영속성 확보
- 기존 데이터셋 번호 체계의 유무 — URI 경로에 반영
- 식별자 발급·회수 관리 주체 — 중복 발급 방지
이 페이지의 규칙은 잠정 규칙입니다. 조직의 정책이나 상위 지침이 마련되면 그 정책이 우선하며, 이미 부여한 식별자는 유지합니다.
완료 확인
- 데이터셋 식별자를 URI 형식으로 결정
- 연도·버전·파일 형식·부서명·포털 목록키 미포함 확인
- 식별자·랜딩 페이지·접근 주소가 서로 다른 값인지 확인
다음 단계: 결정한 식별자를 데이터 설명서의 dct:identifier에 기재하고 데이터 설명서 작성의 완료 확인을 마친 뒤, 품질 측정과 결과서(2단계)로 진행합니다.
근거: 제3부 부속서 A.1 · 잠정 규칙은 이 사이트의 권고
데이터 준비 › 절차
품질 측정과 결과서 (2단계)
2단계에서는 진단 도구가 품질 지표를 측정해 결과서(진단 리포트)를 만듭니다. 담당자는 측정에 필요한 자료를 준비하고, 결과서에서 측정 완성도와 측정하지 못한 지표의 사유를 확인합니다. 진단 도구의 배포 버전은 개발 중이므로, 결과서를 읽는 방법은 공공데이터 예제의 결과서를 참고합니다.
1. 측정 자료 준비
측정할 수 있는 지표의 수는 데이터 유형과 담당자가 갖춘 자료에 따라 달라집니다. 표 형태 예시 파일은 파일만으로 정식 필수 지표 13개 중 6개를 측정했고, 1단계 데이터 설명서를 갖춘 뒤에는 7개를 측정했습니다. 나머지 지표는 외부 자료가 있어야 측정할 수 있으므로, 데이터에 해당하는 다음 자료를 미리 준비합니다.
- 데이터 파일과 1단계 데이터 설명서(컬럼 정의서 포함)
- 코드표와 그 판
- 기준 시점과 갱신 이력
- 컬럼별 값 범위와 필드 간 관계 규칙
점수 계산과 측정 완성도 판정은 진단 도구가 수행하며, 담당자가 측정식을 직접 적용하지 않습니다. 단계별 측정 결과는 예시 데이터로 따라가기에 있습니다.
2. 점수와 등급의 구분
표준은 품질을 7개 차원 16개 지표로 측정합니다. 차원은 완전성(D1)·일관성(D2)·정확성(D3)·적시성(D4)·유효성(D5)·유일성(D6)·기계 판독성(D7)입니다. 파일을 열 수 없으면 나머지 차원을 측정할 수 없으므로, 진단 도구는 기계 판독성을 먼저 확인합니다.
점수와 품질 등급은 서로 다른 값입니다. 진단 도구가 지표와 차원의 점수를 계산하고, 품질 등급은 운영 지침의 임계 프로파일(판정 기준값)로 판정합니다. 등급 판정은 평균이 아니라 7개 차원 가운데 가장 낮은 점수에서 출발하며, 같은 점수라도 적용한 운영 지침이 다르면 등급이 달라질 수 있습니다. 운영 지침을 적용하지 않은 결과서는 품질 등급을 「판정하지 않음: 운영 지침 미적용」으로 기록합니다.
운영 지침이 없을 때의 측정 결과
운영 지침이 없을 때 측정한 결과도 유효한 기초 자료이므로 점수와 미측정 사유를 보관합니다. 운영 지침을 적용할 때 측정 방법이 달라지는 지표(예: D5-03의 더미값 패턴)는 다시 측정하고 새 결과서를 발행합니다.
표준 제2부 부록 Ⅰ의 예시 임계 프로파일은 상태가 EXAMPLE이며, 잠정 계산과 도구 개발에만 사용하고 등급 판정에는 사용하지 않습니다. 표준 제공 운영 지침은 표준 제정 시(2026년 12월 예상) 공개되며, 조직·기관은 자체 운영 지침을 구성해 등급을 판정할 수 있습니다. 같은 점수가 기준값에 따라 다른 등급이 되는 과정은 운영 지침 구성의 모의 계산에서 확인할 수 있습니다.
3. 측정 완성도 확인
결과서는 점수와 별도로 측정 완성도(표준 용어: 진단 성숙도, DM)를 기록합니다. 측정 완성도는 요구된 지표를 어디까지 측정했는지를 나타내며, 그 유형의 정식 필수 지표를 모두 측정해야 DM-2가 됩니다. 운영 지침을 적용했더라도 DM-2가 아니면 점수와 관계없이 품질 등급은 「판정하지 않음: DM-2 미달」입니다. 파일이 비어 있거나(레코드 0건) 손상되어 열리지 않으면 측정 완성도와 등급 모두 「판정하지 않음」으로 기록합니다.
운영 지침이 없으면 진단 도구는 최소 측정 지표인 D5-03(통계적 타당성)을 표준 제2부 부록 Ⅰ의 예시 패턴으로 잠정 측정하고, 평가 상태를 PROVISIONAL로 기록합니다. 예시 파일과 공공데이터 예제의 표 형태·시계열 데이터는 코드표 등 외부 자료가 없어 정식 필수 지표를 모두 측정하지 못했으므로 DM-0(잠정)입니다.
지표 적용성 5개 값과 담당자 조치
| 적용성 값 | 뜻 | 담당자 조치 |
|---|---|---|
APPLIED | 지표를 측정하고 점수를 기록함 | 없음 |
PARTIALLY_APPLIED | 기준 자료가 있는 대상만 측정함. 점수 미기록(null) | 나머지 대상의 기준 자료 확보 |
PRECONDITION_UNMET | 기준 자료(예: 코드표)가 없어 측정하지 못함 | 기준 자료 확보 후 재측정 |
NOT_APPLICABLE | 그 유형이나 조건에 적용되지 않음. 결손이 아님 | 없음 |
OPTIONAL_SKIPPED | 선택 지표를 측정하지 않음 | 없음 |
정식 필수 지표 가운데 PARTIALLY_APPLIED가 하나라도 있으면 DM-2가 성립하지 않습니다. 결정표의 줄별 조건은 판정 절차, 상태값의 전체 목록은 상태값과 판정값에 있습니다.
공공데이터 예제의 측정 완성도
| 예제 | 측정한 정식 필수 지표 (정제본) | 측정 완성도 | 남은 원인 |
|---|---|---|---|
STRUCT × KG | 11 / 13 | DM-0(잠정) | 미측정 2개 — 표준산업분류·법정동 코드표 값 미확보(D2-02 부분 측정) 외 1개 |
TSERIES × Stats | 10 / 13 | DM-0(잠정) | 미측정 3개 |
TEXT × RAG | 5 / 5 | DM-2 | 없음 |
PT × FineTuning | 7 / 8 | DM-0 | D3-02(라벨 정확성) — 전문가 검수 결과 필요 |
문서 유형에는 D5-03이 적용되지 않으므로, 문서 예제는 운영 지침이 없어도 정식 필수 지표 5개를 모두 측정해 DM-2가 되었습니다. 이미지(IMAGE)도 D3-02에 전문가 검수 결과가 필요합니다. DM-1은 측정 충족률이 운영 지침의 하한 이상인지로 판정하므로, 운영 지침이 없으면 판정하지 않습니다.
4. 결과서 읽기
결과서를 받으면 측정 완성도를 먼저 확인하고, DM-2가 아니면 측정하지 못한 지표와 그 사유를 확인합니다. 다음으로 가장 낮은 차원 점수를 확인하며, 그 차원이 수정 대상입니다. 가중 평균은 참고값이며 등급 판정에 사용하지 않습니다. 등급이 기재되어 있으면 적용한 운영 지침의 식별자와 버전을 함께 확인합니다.
측정하지 못한 지표는 필요한 자료에 따라 3개 유형으로 분류합니다.
- 즉시 수행: 레코드 키 지정, 기재 항목 입력처럼 추가 자료가 필요 없는 작업
- 자료 확보 후 수행: 코드표를 확보하면 D2-02(참조 무결성)·D3-01(표준 명칭 정합성)을 측정할 수 있음
- 담당자 범위 외: 운영 지침 적용 후의 등급 판정. 사유를 기록하고 대기
결과서의 6개 값
| 값 | 답하는 질문 | 값의 형태 |
|---|---|---|
| 지표 적용성 | 지표를 측정했는가 | APPLIED 등 5개 값 |
| 지표 점수 | 측정한 지표의 값은 얼마인가 | 0 이상 1 이하 |
| 미측정 사유 | 왜 측정하지 못했는가 | 적용성 값과 함께 기록하는 사유 문장 |
| 측정 완성도 | 요구된 지표를 어디까지 측정했는가 | DM-0 · DM-1 · DM-2 · 판정하지 않음 |
| 품질 등급 | 측정한 품질이 어느 수준인가 | Tier 0~4 · 판정하지 않음 (운영 지침 필요) |
| 준비 상태 | 데이터가 어느 상태에 있는가 | Discoverable · Quality-Ready · Purpose-Ready |
품질 등급과 준비 상태
공공데이터 예제 4종의 품질 등급은 모두 「판정하지 않음: 운영 지침 미적용」이며, DM-2인 문서 예제도 같습니다. 이 사이트는 예시 임계 프로파일로 등급을 부여하지 않습니다. 조직이 자체 운영 지침으로 등급을 판정하면 등급과 함께 운영 지침의 식별자·버전을 기재하고 그 운영 지침을 공개합니다.
Quality-Ready로 전이하려면 측정 완성도 DM-2, 운영 지침 적용, 품질 등급 Tier 1 이상의 3개 조건을 모두 충족해야 합니다. 따라서 4개 예제의 준비 상태는 Discoverable입니다.
완료 확인
- 측정에 필요한 자료 준비
- 결과서의 측정 완성도와 미측정 사유 확인
- 측정하지 못한 지표를 3개 유형으로 분류
다음 단계: 결함 수정(2단계)
근거: 제1부 5.1, 5.2 · 제2부 5.1, 5.2, 7.3, 8.1, 부속서 A.4.1, B.2, B.5 표 B.4, 부록 Ⅰ
데이터 준비 › 절차
결함 수정 (2단계)
결과서에서 점수가 낮은 지표를 확인했으면, 고칠 수 있는 값은 정제본에서 수정하고 고칠 수 없는 한계는 기록합니다. 원본 파일은 덮어쓰지 않고 정제본·결과서와 구분해 보관합니다.
1. 값 수정
수정은 점수가 가장 낮은 차원부터 시작합니다. 등급 판정이 가장 낮은 차원 점수에서 출발하기 때문입니다. 대부분의 작업은 컬럼명과 표기의 통일, 식별자·분류체계·표준 코드에 맞춘 값 정리, 측정 결과와 한계를 데이터 설명서에 기재하는 설명 보강으로 이루어집니다.
| 점수가 낮은 차원 | 우선 조치 |
|---|---|
| 완전성(D1) | 핵심 컬럼의 빈 값 확인. 채울 수 없으면 빈 값 표기를 통일하고 그 사실을 기재 |
| 일관성(D2) | 같은 개념의 다른 이름 확인, 날짜·코드 표기 통일 |
| 정확성(D3) | 원천 자료와 대조. 기준 자료가 없으면 「정확성 미측정」으로 두고 사유 기재 |
| 적시성(D4) | 기재한 갱신 주기를 실제 갱신 이력과 일치시킴. 지킬 수 있는 주기만 기재 |
| 유효성(D5) | 자료형·허용값·필수값 규칙을 정의하고 위반 행 확인 |
| 유일성(D6) | 레코드 키 정의. 키가 없으면 레코드 단위 중복 판정이 불확실 |
| 기계 판독성(D7) | 1단계에서 정리하지 못한 경우 개방 형식 변환, 셀 병합·소계 행·여러 줄 머리글 제거 |
수정한 내용·일자·버전 변경·사유는 처리 이력에 기록합니다. 처리 이력이 없으면 이용자가 정제 결과를 검증할 수 없습니다. 예를 들어 「2026-08-14, 구 단위 누락값 보정, 원본 v1.0.0 → 정제본 v1.1.0」과 같이 기록합니다.
2. 한계 기록
수정하지 못하는 한계는 반드시 기록합니다. 이용자는 기록된 한계를 근거로 데이터의 사용 여부와 범위를 판단하며, 기록되지 않은 제약은 확인할 수 없습니다. 한계 기록은 결함 판정이 아니라 활용 범위를 판단하기 위한 정보입니다.
- 알려진 치우침: 전국 대상이나 수도권 데이터가 90% 이상
- 부적합한 용도: 주민등록 기준 통계로 실제 상주 인구 분석에는 부적합
- 빠진 값의 원인: 센서 점검(2.1%)·통신 오류(1.1%)로 결측 발생
- 측정하지 못한 사유: 대조할 원천 자료가 없어 정확성 미측정
3. 파일 관리와 재측정
정제본은 다른 데이터셋이 아니므로 고유 식별자를 그대로 사용하고, 원본과는 배포 자원과 SHA-256 체크섬으로 구분합니다. 데이터를 정제하거나 다시 측정했으면 새 결과서를 만들고, 데이터 설명서도 새 버전으로 발행해 새 결과서를 주소와 체크섬으로 가리킵니다. 정제본을 다시 측정하려면 진단 도구가 필요하며, 배포 버전은 개발 중입니다.
파일별 구분 방법과 결과서 재사용 조건
| 구분 대상 | 구분 방법 |
|---|---|
| 원본 파일과 정제본 | 배포 자원과 SHA-256 체크섬 |
| 배포 버전 | 버전 번호 |
| 데이터 설명서 | 버전마다 새로 발행하고 이전 버전을 가리킴 |
| 결과서 | 측정할 때마다 새로 생성 |
| 목적별 운용 파일 | 활용 목적 유형마다 별도 파일 |
기존 결과서는 측정 대상 버전, 측정 규칙, 적용한 운영 지침, 측정 시점의 유효성이 모두 같을 때만 그대로 사용합니다.
자주 나오는 오류
| 잘못된 예 | 바로잡은 예 |
|---|---|
| 차원 점수를 가중 평균 0.925로 요약해 등급 판단 | 최소 차원 점수(D4 0.86)에서 후보 등급 산정. 평균은 낮은 차원 점수를 희석함 |
| 운영 지침 없이 예시 임계 프로파일로 계산한 등급 공개 | 점수와 측정 완성도만 기록하고 품질 등급은 「판정하지 않음: 운영 지침 미적용」 |
| 정제한 뒤 이전 결과서를 그대로 둠 | 새 결과서를 생성하고 데이터 설명서가 새 결과서를 가리키도록 갱신 |
품질 점수와 등급은 AI 활용을 위해 표준이 추가한 요건이며, 국제 FAIR 원칙은 이를 요구하지 않습니다.
완료 확인
- 정제본 작성과 처리 이력 기록
- 고칠 수 없는 한계 기록
- 원본 보존 (정제본과 다른 파일·다른 체크섬)
다음 단계: 팩 구성과 배포
근거: 제3부 5.1
데이터 준비 › 절차
팩 구성과 배포
팩(Pack)은 준비를 마친 데이터를 배포하는 단위로, Quality-Ready 이상에서 구성합니다. 데이터 설명서가 결과서와 운용 파일을 주소와 SHA-256 해시로 가리키며, 데이터 파일 자체는 팩에 넣지 않습니다. Discoverable 상태에서는 팩 대신 데이터 설명서를 공개합니다.
1. 구성 원칙
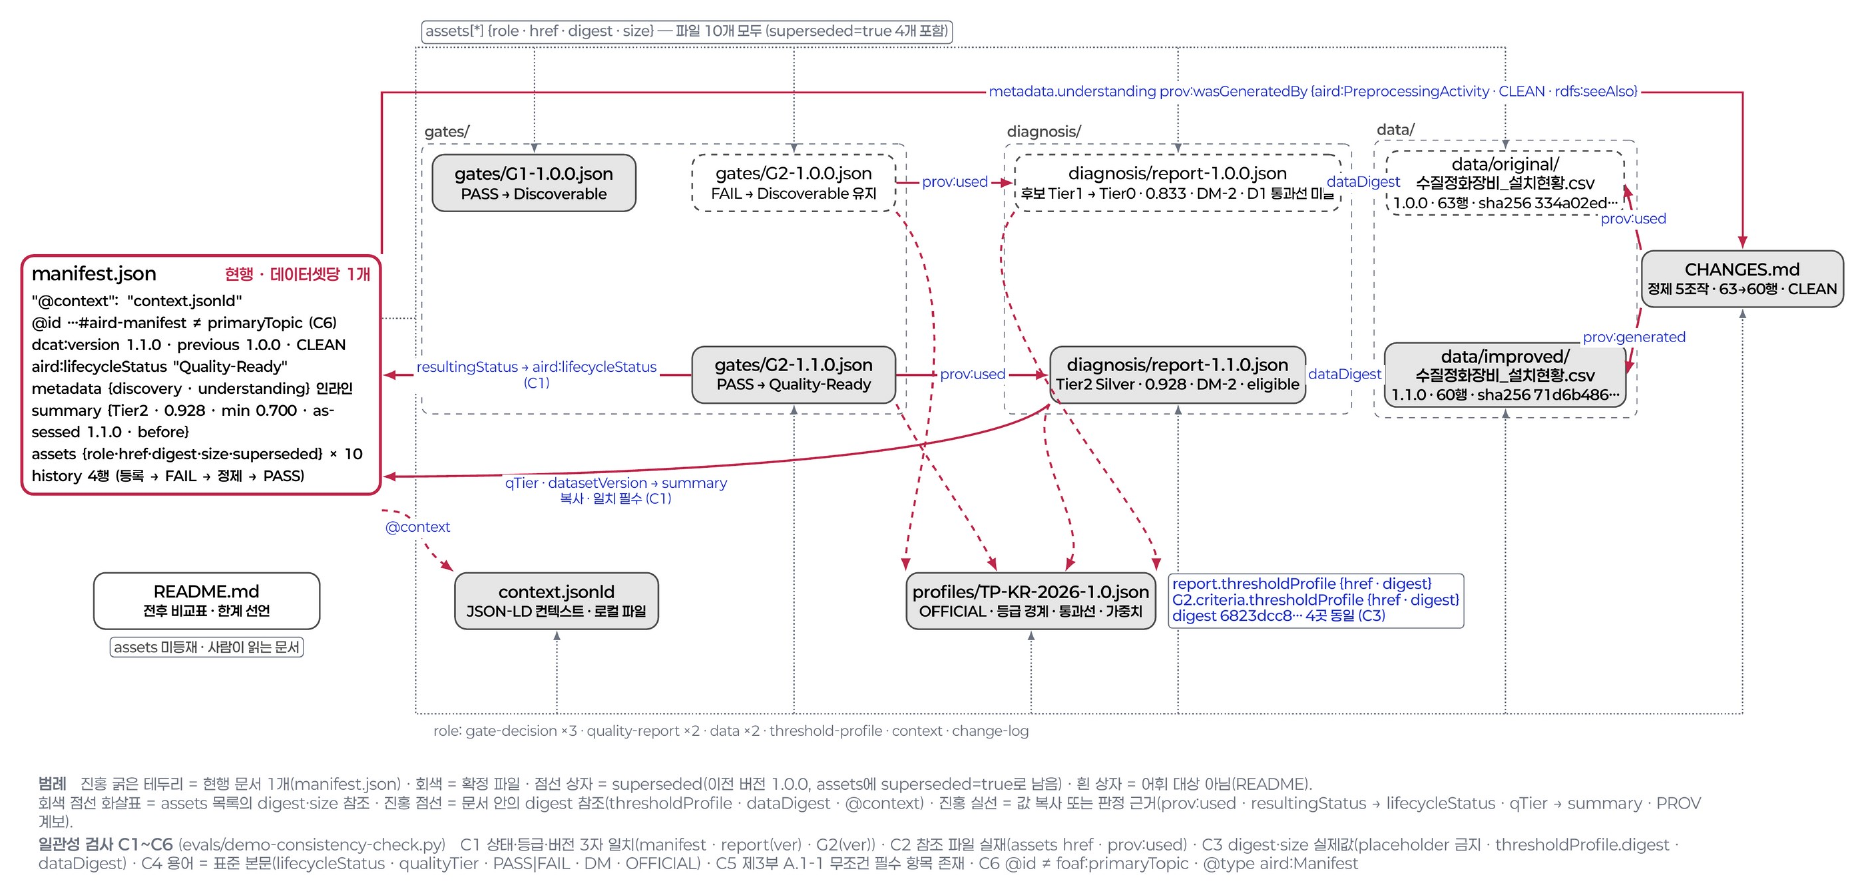
데이터셋은 기술의 대상(실체)이고 데이터 설명서는 그 데이터셋을 기술하는 문서이므로, 두 식별자는 서로 다릅니다. 데이터 설명서는 결과서·운용 파일·데이터 파일을 주소와 해시로 가리키고, 결과서 값의 일부를 이해 계층에 요약해 기재합니다. 품질 판정의 원본은 결과서이며, 요약 값이 결과서와 다르면 결과서 값이 우선하고 검증에 실패합니다.
팩의 파일 배치와 묶음 형식은 운영 지침이 정합니다. 표준 제공 운영 지침은 표준 제정 시(2026년 12월 예상) 공개되며, 이 페이지의 파일 이름과 주소는 모두 예시입니다.
2. 준비 상태별 필요한 파일
상태가 올라갈수록 이전 상태의 파일과 기재 범위에 새 항목이 추가됩니다. 아래에서 상태를 선택하면 필요한 파일이 표시되고, 파일을 선택하면 표준 근거와 다른 파일을 가리키는 방식을 확인할 수 있습니다.
상태를 고르면 그 상태에 필요한 파일만 밝게 표시됩니다. 파일을 고르면 표준 근거와 다른 파일을 가리키는 방식이 나타납니다. 파일 이름 · 주소 · 해시 · 점수는 모두 설명용 가상 값입니다.
표로 보기
| 준비 상태 | 필요한 파일 | 전이 판정 |
|---|---|---|
| Discoverable | 데이터 설명서 1개 (컬럼 정의서를 별도 문서로 두면 그 문서 포함) | 확인 지점 ①(G1) — 발견 계층 필수 항목 충족 |
| Quality-Ready | 데이터 설명서 · 결과서 · 팩 마니페스트 | 확인 지점 ②(G2) — 측정 완성도 DM-2, 운영 지침으로 판정한 등급 Tier 1 이상 |
| Purpose-Ready | Quality-Ready 팩 + 활용 목적 유형마다 운용 파일 1개 | 확인 지점 ③(G3) — 등록된 목적 프로파일의 운용 계층 필수 항목 충족 |
결과서 값과 데이터 설명서 요약 항목의 대응
요약 대상 항목은 표준 제2부 표 9-2가 규정합니다. 데이터 설명서의 속성은 어휘표 v0.10.5의 품질 판정(aird:QualityAssessment) 항목이며, 이 대응은 표준 초안 본문에는 없습니다. 예시 값의 등급은 가상의 조직 운영 지침을 적용한 값입니다.
| 제2부 표 9-2 항목 | 결과서 키 | 데이터 설명서 속성 | 예시 값 |
|---|---|---|---|
| 최소 차원 점수 | qualityIndex.minDimensionScore | aird:qualityIndexMin | 0.82 |
| 가중 평균 | qualityIndex.weightedAverage | aird:qualityIndexAvg | 0.91 |
| 최소 측정 지표 점수 | qualityIndex.mmiScore | aird:qualityIndexMMI | 1.0 |
| 품질 등급과 라벨 | qTier.tier · qTier.label | aird:qualityTier · aird:qualityTierLabel | Tier2 · Silver |
| 측정 완성도 | diagnosticMaturity | aird:diagnosticMaturity | DM-2 |
| 데이터 유형 | dataType | aird:dataType | STRUCT |
| 진단 일시 | generatedAt | prov:generatedAtTime | 2026-…T…+09:00 |
| 임계 프로파일 식별 정보 | thresholdProfile | aird:thresholdProfile | 식별자 · 1.0 · 해시 · OFFICIAL |
| 판정 규칙·스키마 버전 | diagnosticInfo.ruleVersion · schemaVersion | aird:ruleVersion · aird:schemaVersion | … |
| 전이 적격성 | qTier.qualityReadyEligible | aird:qualityReadyEligible | true |
3. 배포 전 검증
팩이 포함하거나 참조하는 모든 파일에는 SHA-256 해시를 기재하며, 해시가 하나라도 일치하지 않으면 검증에 실패하고 효력 정지(Stale) 사유가 됩니다. 배포 전에 다음 5가지를 확인합니다.
- 결과서 참조: 데이터 설명서가 가리키는 결과서의 주소가 유효하고 해시가 일치함
- 요약 값 일치: 데이터 설명서의 요약 값이 결과서의 값과 일치함
- 이해 계층 완비: 선언한 상태의 필수 항목과 참조 무결성을 모두 갖춤
- 상태와 기재 범위 일치: 선언한 상태와 실제 기재한 계층의 범위가 일치함 (넓어도 좁아도 실패)
- 파생물의 버전 일치: 운용 파일의 기반 데이터 버전이 결과서의 데이터셋 버전과 일치함
검증을 통과해도 Quality-Ready로 바로 전이하지는 않으며, 확인 지점 ②(G2)를 통과해야 전이합니다.
4. 배포와 게시
데이터 파일은 원래 배포처(공공데이터포털·사내 저장소)에 두고, 데이터 설명서와 팩 파일은 이용자와 에이전트가 내려받을 수 있는 공개 주소로 제공합니다. 공공데이터는 포털 상세 화면 주소를 랜딩 페이지(dcat:landingPage)에 기재합니다. 데이터를 수정하거나 다시 측정하면 데이터 설명서를 새 버전으로 발행하고, 이전 버전의 파일은 변경하지 않습니다. 탐색·교환·활용은 후속 부(제5부)에서 다룹니다.
공공데이터 예제 4종은 운영 지침을 적용하지 않아 Discoverable 상태이므로 팩으로 배포하지 않았습니다. 데이터 설명서의 전체 예시는 마니페스트 예시에 있습니다.
완료 확인
- 선언한 준비 상태에 필요한 파일 구비
- 참조하는 모든 파일에 SHA-256 해시 기재
- 데이터 파일을 팩에 넣지 않음
- 요약 값과 결과서 값 일치 확인
다음 단계: 예시 데이터로 따라가기
근거: 제1부 3.15, 5.5 · 제2부 9.2, 표 9-2 · 제3부 5.1, 5.2, 5.3, 9.2, 9.3, 표 9-3
데이터 준비 › 예제
예시 데이터로 따라가기
예시 파일 한 건(사업장 등록 정보 20건)에 준비 절차를 차례로 적용해, 단계마다 기재한 내용과 측정 결과의 변화를 보여 줍니다. 1단계를 마치면 측정한 정식 필수 지표가 13개 중 6개에서 7개로 늘고, 에이전트가 추정해야 하는 판단은 10개에서 2개로 줄어듭니다. 이 과정에서 데이터값은 변경하지 않습니다.
예시 파일은 실재하는 조직이나 데이터를 가리키지 않는 가상 데이터이며, 수치는 이 사이트의 측정 엔진(시험용)으로 측정한 값입니다. 실제 에이전트의 행동과 답의 정확도에 주는 효과는 아직 측정하지 않았습니다.
① 데이터 확인
원본 파일 example.csv는 20행·8열·UTF-8 인코딩의 CSV 파일이며, 시작 시점에는 파일만 있고 설명은 없습니다. 행과 열이 있고 컬럼마다 자료형이 정해지므로 유형은 표 형태(STRUCT)입니다. 사업장명은 법인 정보이지만 개인사업자의 사업장명은 개인정보에 해당할 수 있으므로, 개인정보 보호 담당 부서와 함께 확인합니다.
| bizId | bizName | industryCode | regionCode | employeeCount | revenueBand | registeredOn | closedFlag |
|---|---|---|---|---|---|---|---|
| B-2019-0001 | 가온정밀 | C29294 | 11680 | 42 | B3 | 2019-03-11 | 0 |
| B-2019-0014 | 대성포장 | C22240 | 41135 | 17 | B2 | 2019-05-02 | 0 |
| B-2019-0033 | 한별전자 | C26429 | 28185 | 133 | B4 | 2019-07-19 | 0 |
② 데이터 설명서 작성
담당자는 기재 항목 23개와 컬럼 정의서를 작성했습니다. 예시 조직에는 식별자 발급 정책이 없으므로 고유 식별자 결정의 기본 형식을 적용했고, 데이터셋 식별자는 https://data.example.go.kr/id/dataset/biz-registry입니다. 체크섬과 미디어 타입은 측정 엔진이 파일에서 계산했습니다.
기재 항목 23개의 값
| 항목 | 기재한 값 |
|---|---|
| 데이터셋 식별자 | https://data.example.go.kr/id/dataset/biz-registry |
| 제목 · 설명 | 예시 사업장 등록 정보 · 지역별 사업장의 등록 정보와 영업 상태를 수록한 데이터셋 |
| 키워드 | 사업장 · 산업분류 · 지역 · 영업상태 (4개) |
| 데이터 서비스 유형 · 구조 유형 | FILE · Structured |
| 언어 · 라이프사이클 상태 | KOR · Discoverable |
| 주제 분류 · 랜딩 페이지 | INDUSTRY_EMPLOYMENT · https://data.example.go.kr/dataset/biz-registry |
| 생산 주체 · 제공 주체 | 예시기관 |
| 관리 부서 · 연락처 | 예시기관 데이터관리팀 · data@example.go.kr |
| 생성 방법 · 갱신 주기 | collected · ANNUAL |
| 라이선스 · 이용 조건 | KOGL-1 · 공공누리 제1유형. 출처를 표시하면 상업적 이용과 변형을 허용합니다. |
| 접근 권한 | PUBLIC |
| 접근 주소 · 파일 형식 | https://data.example.go.kr/aird/.../example.csv · CSV |
| 미디어 타입 · 체크섬 | text/csv · 7ad8add25d7a6383… (SHA-256, 측정 엔진이 계산) |
값 목록 항목은 표기 값으로 선택하며, 데이터 설명서에는 어휘표의 개념 URI로 기재합니다. 완성한 파일은 마니페스트 예시에 있습니다.
컬럼 정의서 8개 컬럼
| 컬럼 | 자료형 | 설명 |
|---|---|---|
bizId | string | 사업장 고유 등록번호. B-YYYY-NNNN 형식. 필수 컬럼 |
bizName | string | 사업장 명칭 |
industryCode | string | 한국표준산업분류 세세분류 코드 |
regionCode | string | 행정표준코드 법정동 시군구 코드 |
employeeCount | integer | 상시 종업원 수. 0 이상 100000 이하 |
revenueBand | string | 매출 구간 코드. B1부터 B4까지 |
registeredOn | date | 최초 등록일. ISO 8601-1 날짜 |
closedFlag | integer | 폐업 여부. 0은 영업, 1은 폐업 |
컬럼 정의서의 두 가지 정보가 측정 결과에 영향을 미쳤습니다. bizId에 필수 표시를 달아 D1-01(필수 필드 충족도)을 측정할 수 있게 되었습니다. 반면 employeeCount의 값 범위는 설명 문장에만 적고 자료형의 최소값·최대값으로 기재하지 않아 D5-02(수치 범위 유효성)는 미측정으로 남았습니다. revenueBand의 구간별 의미도 기재하지 않아, 이 예시의 컬럼 정의서는 코드값 의미 기재 기준을 아직 충족하지 못합니다. 두 항목은 아래 「남은 작업」에서 보완합니다.
③ 품질 측정
측정 엔진으로 예시 파일을 두 번 측정했습니다. 첫 번째는 파일만 있을 때이고, 두 번째는 1단계를 마치고 레코드 키를 bizId로 지정한 뒤입니다.
| 항목 | 파일만 | 1단계 후 |
|---|---|---|
| 기재 항목 | 1 / 23 | 23 / 23 |
| 컬럼 설명 | 0 / 8 | 8 / 8 |
| 측정한 정식 필수 지표 | 6 / 13 | 7 / 13 |
| 측정 완성도 | DM-0 (잠정) | DM-0 (잠정) |
| 품질 등급 | 판정하지 않음: 운영 지침 미적용 | 판정하지 않음: 운영 지침 미적용 |
| 에이전트가 추정해야 하는 판단 | 10 | 2 |
에이전트 판단 수는 측정 엔진(시험용)이 4가지 판단(적합성·신뢰성·결합성·사용 가능성)마다 이 예시 파일에서 확인하는 항목 16개를 기준으로 셌으며, 그중 2개는 표준이 답하지 않는 항목입니다. 에이전트가 읽는 것의 24개는 에이전트가 필요로 하는 정보 전체와 표준의 대응을 정리한 목록으로, 기준이 다릅니다. 파일만 있을 때 충족한 기재 항목 1개는 측정 엔진이 계산한 체크섬입니다. 1단계 후 측정한 지표는 D1-01 하나가 늘었고, 최소 측정 지표 4종은 두 번 모두 측정했습니다. D5-03은 운영 지침이 없어 표준 제2부 부록 Ⅰ의 예시 패턴으로 잠정 측정했습니다. 정식 필수 지표 13개 중 7개만 측정했으므로 측정 완성도는 DM-2가 되지 않으며, 운영 지침도 적용하지 않았으므로 점수가 모두 1.0000이어도 품질 등급은 판정하지 않습니다. 이는 데이터의 결함이 아니라 운영 지침 미적용에 따른 결과입니다.
지표별 점수
| 지표 | 파일만 | 1단계 후 |
|---|---|---|
| D1-01 필수 필드 충족도 | 미측정 | 1.0000 |
| D1-02 필수 메타데이터 항목 충실도 | 0.0435 | 1.0000 |
| D5-01 형식 유효성 | 1.0000 | 1.0000 |
| D5-03 통계적 타당성 · MMI | 1.0000 (잠정) | 1.0000 (잠정) |
| D6-01 유일성 · MMI | 1.0000 (전체 컬럼 조합 기준) | 1.0000 (bizId 기준) |
| D7-01 인코딩 일관성 · MMI | 1.0000 | 1.0000 |
| D7-02 기술적 유효성 · MMI | 1.0000 | 1.0000 |
예시 파일은 형식 오류를 제거한 파일이므로 수정할 값이 없었습니다. 실제 데이터에서는 D5-01·D7-01 등이 1.0000 미만으로 측정될 수 있으며, 실제 공공데이터의 측정 결과는 공공데이터 예제에 있습니다.
미측정 지표 6개와 필요한 자료
| 지표 | 측정에 필요한 자료 |
|---|---|
| D2-01 필드 간 관계 일관성 | 컬럼 정의서 또는 데이터 설명서에 정의한 관계 규칙 |
| D2-02 참조 무결성 | 대조할 마스터 코드 테이블의 실제 값 (주소·참조만으로는 미충족) |
| D2-03 파생값 정확성 | 파생값 계산 규칙의 정의 |
| D3-01 표준 명칭 정합성 | 코드–명칭 대응으로 쓸 수 있는 공인 참조 기준. 데이터에 코드와 명칭이 함께 있어야 함 |
| D4-01 최신성 | 기준 시점과 갱신 이력 |
| D5-02 수치 범위 유효성 | 컬럼별 허용 수치 범위의 정의 (자료형의 최소값·최대값) |
표준의 전제 조건에 따르면 저장된 파생값이 없는 데이터에서 D2-03은 해당 없음(NOT_APPLICABLE)입니다. 이 예시 파일에는 저장된 파생값이 없으므로 D2-03은 해당 없음이지만, 측정 엔진(시험용)은 미측정으로 셌습니다. 표준에 따르면 아래 결과서의 측정 범위는 7/13(0.5385)이 아니라 7/12(약 0.58)입니다.
결과서 발췌
generatedAt              2026-10-05T...
datasetFile              example.csv
fileChecksum             SHA-256 7ad8add2...
dataType                 STRUCT
recordCount              20
indicators               D1-01 1.0 (필수) · D5-01 1.0 (필수) · D5-03 1.0 (필수 · 잠정) · ...
notMeasured              D2-02 (필수): 마스터 코드 테이블의 실제 값을 대조할 것
                         D3-01 (필수): 공인 참조 기준이 필요함
formalAssessmentCoverage 0.5385
diagnosticMaturity       DM-0
assessmentStatus         PROVISIONAL
thresholdProfile         (없음 — 운영 지침 미적용)
note                     D5-03을 부록 Ⅰ 예시 패턴으로 잠정 측정한 결과서다. 공식 공시와 조직 간 비교에 쓰지 않는다.
formalAssessmentCoverage0.5385는 정식 필수 지표 13개 중 7개를 측정했다는 범위값이며, 품질 점수나 등급이 아닙니다.assessmentStatusPROVISIONAL은 D5-03을 예시 패턴으로 잠정 측정했다는 평가 상태입니다.thresholdProfile이 비어 있는 것은 운영 지침을 적용하지 않았기 때문이며, 마니페스트 예시의aird:thresholdProfile: null과 같은 상태입니다.
④ 목적별 준비
예시 데이터로 성립할 수 있는 활용 목적은 기계학습(ML, 정답 컬럼 후보 closedFlag)과 지식그래프(KG, 표준 코드 컬럼 industryCode·regionCode)입니다. 통계 분석·검색증강생성·심층학습·미세조정은 해당하는 데이터가 없어 대상이 아닙니다. 목적 프로파일이 등록되지 않았으므로 목적 등급은 「판정하지 않음」으로, 사유는 PROFILE_NOT_REGISTERED(목적 프로파일 미등록)로 기재합니다. 3단계는 활용 목적이 확정된 뒤 목적 유형마다 운용 파일을 만들어 수행합니다.
남은 작업
예시 파일은 1단계 기재와 2단계 측정까지 마쳤고, 측정 완성도 DM-2·품질 등급·목적별 운용 파일이 남아 있습니다. 남은 작업은 사유별로 구분해 기록하며, 데이터 자체의 미충족과 운영 지침 미적용을 혼용하지 않습니다.
- 즉시 수행:
revenueBand의 구간별 의미와employeeCount의 값 범위(최소값·최대값)를 컬럼 정의서에 기재 → D5-02 측정 가능. 고칠 수 없는 한계 기록 (예: 「폐업 신고 지연으로closedFlag가 실제보다 늦게 반영될 수 있음」) - 자료 확보 후 수행: 산업분류·법정동 코드표 확보 → D2-02, 코드–명칭 대응 자료 확보 → D3-01, 기준 시점과 갱신 이력 정리 → D4-01
- 담당자 범위 외: 운영 지침을 적용해 재측정 → 새 결과서와 그 운영 지침 기준의 등급. 표준 제공 운영 지침(2026년 12월 예상) 또는 조직이 구성·공개한 운영 지침이 필요
다음 단계: 공공데이터 예제 — 실제 공공데이터 4종의 측정 결과
근거: 제1부 5.6 표 5-5 · 제2부 부록 Ⅰ · 사유 목록은 상태값과 판정값
데이터 준비 › 예제
공공데이터 예제
실제 공공데이터 4종을 측정한 결과입니다. 1단계 기재만으로 측정할 수 있는 지표가 늘었고, 측정이 드러낸 결함은 데이터 유형마다 달랐습니다. 측정일은 2026년 10월 6일이며, 운영 지침을 적용하지 않아 품질 등급은 판정하지 않았습니다.
1. 예제 구성
각 예제는 데이터 유형 하나와 대표 활용 목적 하나를 짝지어 실제 공공데이터로 구성했습니다.
| 예제 | 유형 × 목적 | 규모 |
|---|---|---|
| 상가(상권)정보 — 세종 표본 | STRUCT × KG | 15,816행 |
| 시간별 전국 전력수요량 (2025년) | TSERIES × Stats | 8,760시점 |
| 공공데이터법·인공지능데이터행정법 조문 말뭉치 | TEXT × RAG | 4판 · 209조 · 673단위 |
| 법령해석례 질의–회답 쌍 | PT × FineTuning | 51건 → 쌍 45 |
원천 데이터
- 상가(상권)정보: 소상공인시장진흥공단 · 공공데이터포털 15083033 (202606판)
- 전력수요량: 한국전력거래소 · 공공데이터포털 15065266
- 조문 말뭉치: 법제처 국가법령정보센터 본문 PDF 저장본 (현행·시행 예정 판)
- 법령해석례: 법제처 Open API target=expc (목록 8,881건에서 안건명·본문 검색으로 51건 선정), 대조용으로 target=kostatCgmExpc 국가데이터처 해석 7건
2. 1단계 기재 전후의 측정 지표
예제마다 원본을 1단계 전에 한 번, 같은 원본을 1단계 후에 한 번, 결함을 수정한 정제본을 한 번 측정했습니다. 1단계에서는 필수 필드·형식·값 범위·필드 간 관계·파생 규칙·코드표를 컬럼 정의서에 기재했습니다. 원본에서 1단계 후로 가는 동안 데이터값은 변경하지 않았지만 측정한 지표가 늘었습니다. 1단계에서 기재한 정의가 2단계 측정의 입력이 되기 때문입니다.
| 예제 | 원본 · 1단계 전 | 원본 · 1단계 후 | 정제본 |
|---|---|---|---|
STRUCT × KG | 5 / 13 | 11 / 13 | 11 / 13 |
TSERIES × Stats | 5 / 13 | 10 / 13 | 10 / 13 |
TEXT × RAG | 3 / 5 | 4 / 5 | 5 / 5 |
PT × FineTuning | 4 / 8 | 7 / 8 | 7 / 8 |
유형별 측정 완성도는 결과서 읽기에 있습니다.
3. 측정이 드러낸 결함
표 형태 데이터에서는 명칭과 코드의 불일치가, 시계열 데이터에서는 인코딩과 빈 행이, 문서와 질의–회답 쌍에서는 판 구분과 중복이 주로 드러났습니다. 지표 점수가 1.0이어도 결함이 남을 수 있습니다. 예를 들어 식별자 기준의 D6-01(유일성)은 식별자만 다르고 내용이 같은 행을 찾지 못하므로, 이러한 결함은 3단계 목적별 준비에서 처리합니다.
유형별 결함과 처리 (13건)
| 유형 | 결함 | 지표 | 처리 |
|---|---|---|---|
STRUCT | 소분류명의 쉼표가 세미콜론으로 바뀜 (61셀) | D3-01 표준 명칭 정합성 | 코드표 명칭으로 교체 → 1.0 |
STRUCT | 상가업소번호만 다르고 나머지 38개 컬럼이 같은 행 82개 | D6-01 1.0 (식별자 기준) | 목적별 준비(KG)의 개체 후보로 처리 |
STRUCT | 법정동명에 리를 적지 않음 — 「금남면」 하나에 법정동코드 26개 | — | KG 개체 식별자로 법정동코드 사용 |
STRUCT | 표준산업분류·법정동 코드표의 값을 구하지 못함 | D2-02 부분 측정 (측정 범위 0.6) | 코드표 파일을 구해 측정 |
TSERIES | CP949 인코딩 | D7-01 0.0 | UTF-8로 다시 저장 → 1.0 |
TSERIES | 끝 빈 행 (포털 366행 · 실제 365행) | D1-01 1 미만 | 빈 행 제거 |
TSERIES | 단위가 설명문에만 있음 | — | 컬럼 설명에 단위 기재 |
TEXT | PDF 머리글·바닥글이 본문에 혼입되고 시행일이 머리 한 줄에만 있음 | D7-01 | 조 단위로 분할하고 근거 위치에 시행일 기재 |
TEXT | 같은 법령의 현행판과 시행 예정판 | — | valid_from·valid_to로 판 구분 |
TEXT | 갱신 주기 「수시」 | D4-01 미측정 | 갱신 약속을 주기 값으로 기재 |
PT | 내용이 같고 안건번호만 다른 해석 6쌍 | D6-01 1.0 | 운용 파일에서 쌍마다 한 건만 유지 |
PT | 질의기관명 빈 값 7건 | D1-01 0.983 → 1.0 | 안건명 머리말에서 복원하고 출처 기록 |
PT | 2018년 해석이 2022년에 삭제된 조문을 인용 | — | 「삭제된 조」로 표시하고 현행 조문에 연결하지 않음 |
4. 카탈로그 관측 사례
포털 등록을 마친 데이터도 AI 활용 준비는 별도로 필요합니다. 산업단지 기업정보(379행·9개 컬럼·CSV) 1건의 목록 메타데이터를 표준 초안 필수 기재 항목 19개와 대조한 결과, 포털에 이미 있는 항목은 6개, 형식만 변환하면 되는 항목은 3개, 새로 작성해야 하는 항목은 10개였습니다.
항목별 분류와 관측 결과
| 구분 | 항목 |
|---|---|
| 포털 기재 항목 (6) | 제목 · 제공기관 · 파일 형식 · 접근 주소 · 설명 · 키워드 |
| 형식 변환 대상 (3) | 갱신 주기 · 미디어 타입 · 데이터 서비스 유형 |
| 신규 작성 대상 (10) | 데이터셋 식별자 · 언어 · 라이프사이클 상태 · 생산 주체 · 연락처 · 생성 방법 · 라이선스 · 이용 조건 · 접근 권한 · 체크섬 |
| 미분류 (4) | 데이터셋 구조 유형 · 주제 분류 · 랜딩 페이지 · 관리 부서 — 관측 이후 데모 프로파일에 추가된 항목 |
포털이 컬럼 구조 정보를 제공하면 파일 없이도 컬럼 정의서 초안을 만들 수 있습니다. 이 사례에서는 관측된 컬럼명·자료형·고유값 수로 9개 컬럼의 초안을 만들었으며, 담당자는 각 컬럼의 설명을 추가로 기재합니다. 관측 결과는 개인정보 확인 대상도 표시하며, 이 사례에서는 전화번호 컬럼이 공개 범위를 담당 부서와 확인할 항목으로 표시되었습니다. 기관명은 표기하지 않았습니다.
완료 확인
- 자기 데이터와 유형이 같은 예제 확인
- 그 예제에서 1단계 기재 후 늘어난 측정 지표 수 확인
- 자기 데이터에 같은 결함(CP949 인코딩·끝 빈 행·설명문에만 있는 단위 등)이 있는지 확인
다음 단계: 자기 데이터로 데이터 확인부터 시작합니다.
근거: 측정 결과는 이 사이트의 측정 엔진(시험용) 실측값 · 관측 기준은 제3부 부속서 A.1
에이전트가 읽는 것
에이전트가 데이터를 활용하기 전에 내리는 4가지 판단에 필요한 정보 24개를 표준의 조항·기재 항목과 대조한 결과, 표준의 필수 요구는 9개, 부분 대응은 10개, 공백은 5개입니다.
에이전트는 점수 하나가 아니라 구조화된 필드와 측정 근거로 판단합니다. 아래 대응표는 표 형태 데이터(STRUCT)를 기준으로 정리했으며, 문서·이미지·지시문·응답 쌍(PT)은 판단에 필요한 정보가 다릅니다.
표준의 대상과 목표
표준의 대상은 공공데이터에 한정되지 않으며, 공공기관·기업·민간 비영리 단체가 발행하거나 제공하는 데이터가 모두 대상입니다. 표준의 목표는 AI 에이전트가 데이터에 접근하고, 이해하고, 신뢰하고, 이용해도 되는지 판단하게 하는 것입니다. 설계는 공공데이터 관측에서 출발했습니다.
판단별 표준의 대응
필수 표준의 필수 요구 · 부분 조건부·선택·권고, 또는 측정하지만 필드로 노출하지 않음 · 공백 필수 항목과 지표에 없음
적합성 — 질문 부합도
판단 질문 · 내 질문에 맞는 데이터인가
적합성 — 질문 부합도 — 표 7행 펼치기
| 필요한 정보 | 표준 | 표준의 대응 |
|---|---|---|
| 시간 범위 | 공백 | 없음 어휘는 DCAT-AP-KR(DCAT)에 있음. AIRD 발견 · 이해 계층의 필수 항목은 아님. 시계열의 기준 시점 · 측정 주기는 권고. 포털 목록의 「시간범위」 채움률 5.2% (공공데이터포털 목록 관측, 2026-08-31) |
| 공간 범위 | 공백 | 없음 시간 범위와 같음. 포털 목록의 「공간범위」 채움률 6.4% |
| 단위 | 부분 | 컬럼 정의서의 단위 (권고) · 시계열 단위 (권고) |
| 수집 대상 모집단 | 부분 | Stats(통계 분석) 목적의 준비 항목 (권고) · rai:dataBiases (알려진 치우침, 필수) |
| 컬럼의 의미 | 필수 | 컬럼 정의서(csvw:tableSchema) (정형 데이터 조건부 필수) |
| 데이터 유형 | 필수 | dct:type · aird:dataType |
| 부적합한 용도 | 필수 | rai:dataLimitations |
신뢰성 — 신뢰 근거
판단 질문 · 신뢰할 수 있는가
마니페스트에 기재된 품질 등급은 표준이 아니라 운영 지침의 임계 프로파일(판정 기준값)로 판정한 값입니다. 등급을 판정한 쪽은 운영 지침의 식별자·버전을 등급과 함께 기재하고 그 운영 지침을 공개하므로, 에이전트는 등급과 함께 판정에 쓴 운영 지침을 읽습니다. 등급을 근거로 쓰는 조건은 판단별 필드와 처리에 있습니다.
신뢰성 대응표(6행)
| 필요한 정보 | 표준 | 표준의 대응 |
|---|---|---|
| 실제 갱신 여부 | 부분 | D4-01 최신성 (필수) · D4-02 갱신 충실도 (STRUCT 선택) 갱신 주기는 필수 기재 항목. 실제 갱신 이력 대조는 선택 지표 |
| 파일 무결성 | 필수 | spdx:checksum · D7-02 기술적 유효성 · 효력 정지(Stale) |
| API 가용성 | 공백 | 제공 시스템의 인터페이스 적합성은 데이터 측 조건과 별도 수준 [제1부 표 6-1] 16개 품질 지표는 파일 기준. 가용성은 데이터에 붙는 사실로 노출되지 않음 |
| API 응답의 명세 일치 | 공백 | 없음 파일의 D7-02에 해당하는 API 측 지표 없음 |
| 값의 형식 · 범위 준수 | 필수 | D5-01 · D5-02 · D5-03 |
| 측정 완성도 | 필수 | 측정 완성도(표준 용어: 진단 성숙도, DM) · 지표 적용성 5값 |
결합성 — 결합 가능성
판단 질문 · 다른 데이터와 결합할 수 있는가
결합성 대응표(4행)
| 필요한 정보 | 표준 | 표준의 대응 |
|---|---|---|
| 영속 식별자 | 필수 | dct:identifier |
| 레코드 키 | 필수 | D6-01 유일성 (식별 컬럼을 지정한 경우) |
| 값 수준에서 확인한 표준코드 | 부분 | D2-02 참조 무결성 · D3-01 표준 명칭 정합성 표준은 코드표의 실제 값 대조를 요구함(주소만으로는 미충족). 컬럼별 결과(코드 체계와 일치율)는 결과서에만 있고 메타데이터 필드로 노출되지 않음 |
| 개체 식별자와 코드표 출처 | 부분 | KG(지식그래프) 목적의 준비 항목 (권고) |
사용 가능성 — 이용 조건
판단 질문 · 이용해도 되는가
사용 가능성 — 이용 조건 — 표 7행 펼치기
| 필요한 정보 | 표준 | 표준의 대응 |
|---|---|---|
| 기계가 읽을 수 있는 라이선스 | 부분 | dct:license (어휘표 kr-license 값 목록 14개 — 공공누리 · CC · CC0) 값 목록이 닫혀 있음. 기업의 자체 이용약관과 MIT · Apache · ODbL 라이선스는 기재할 값이 없음. 값 목록 확장은 어휘표 개정 제안 대상 |
| AI 학습 허용 여부 | 부분 | odrl:hasPolicy (선택) · 공공누리 AI유형 (kr-license) 기계 판독 이용 정책을 담을 자리는 선택 항목. 공공누리 밖의 데이터에는 학습 허용을 뜻하는 라이선스 값이 없음 |
| 자동 수집 허용 여부 | 부분 | odrl:hasPolicy (선택) 사람이 내려받아 이용할 수 있는 데이터도 약관이 자동 수집(예: 웹 크롤링)을 금지할 수 있음. 기업이 무료로 제공하는 데이터의 약관에 이 조항이 있는 사례가 있음 |
| 이용 조건의 버전 | 공백 | dct:rights 고지문 (문자열) 자체 약관은 개정마다 조건이 바뀜. 어느 버전(시행일)의 조건인지 기록하는 필드가 없음 |
| 유상 · 계약 조건 | 부분 | dcatkr:fee (권장) · sc:offers (fee=true일 때 조건부 필수) 가격 · 통화 · 단위는 기재 가능. 무료 할당 뒤 종량제, 계약 고객 한정 조건은 담을 자리가 없음 |
| 접근 조건 | 필수 | dct:accessRights (eu-access: PUBLIC · RESTRICTED · NON_PUBLIC) |
| 개인정보 포함 여부 | 부분 | aird:deidentificationLevel (조건부) · aird:containsPersonalData (조건부) |
대응표 요약
결합성에는 공백이 없습니다. 표준이 코드표의 실제 값 대조를 요구하므로, 남은 과제는 컬럼별 대조 결과를 메타데이터 필드로 노출하는 것입니다.
공백 5개는 적합성·신뢰성·사용 가능성에 있습니다. 에이전트가 데이터를 선별할 때 조건으로 쓰는 정보 가운데 시간·공간 범위는 필수 항목에 없고, AI 학습 허용 여부는 선택 항목에만 있습니다. 또한 16개 품질 지표는 파일을 대상으로 하므로, API로 제공되는 데이터의 가용성과 명세 일치는 데이터에 기재되는 사실로 나타나지 않습니다.
검증된 사실의 노출 제안
표준은 아래 「사실별 표준 현황」 표의 사실 7개 가운데 5개를 이미 측정하지만, 측정 결과는 결과서(표준 용어: 진단 리포트)에만 수록하고 마니페스트에는 차원 점수만 기재합니다. 이 사이트는 측정 결과를 마니페스트에 사실로 노출하는 방식을 제안합니다.
사실별 표준 현황 — 표 7행 펼치기
| 사실 | 판단 | 표준 내 산출 위치 | 표준 현황 |
|---|---|---|---|
update_delay_days | 신뢰성 | D4-01 (경과일수 − 갱신주기) | 측정 결과 미노출 |
api_availability_7d | 신뢰성 | 표준 밖 | 측정하지 않음 |
response_matches_spec | 신뢰성 | 표준 밖 | 측정하지 않음 |
pk_uniqueness | 결합성 | D6-01 | 측정 결과 미노출 |
code_columns_matched | 결합성 | D2-02 (컬럼별) | 측정 결과 미노출 |
encoding | 신뢰성 | D7-01 | 측정 결과 미노출 |
required_fields_nonnull | 적합성 | D1-01 | 측정 결과 미노출 |
노출 방식 제안
dqv:QualityMeasurement로 기재합니다. 사실 1건은 측정 1건이며 다음 항목을 담습니다.
- 지표(
dqv:isMeasurementOf)와 값(dqv:value) - 측정 대상(
dqv:computedOn)과 대상 컬럼 - 시점(
prov:generatedAtTime)과 유효 기간 - 참조 기준(예: 코드표와 그 버전)
다음 단계: 판단별 필드와 처리
근거: 제1부 표 6-1
판단별 필드와 처리
에이전트가 데이터 설명서(마니페스트)에서 판단마다 읽는 필드와 판정 방법을 의사코드로 제시합니다. 필드와 판정값은 표준을 따르고, 판정 규칙은 이 사이트의 권고입니다.
판독 원칙: 표준의 목적은 에이전트가 추정 없이 판단하게 하는 것이므로, 에이전트는 기재되지 않은 필드를 추정값으로 대체하지 않습니다. 근거가 없으면 결과에 「근거 없음」을 밝히고, 사람의 판단이 필요한 경우에는 사람의 확인으로 이관합니다.
적합성 — 질문 부합도
질문에 맞는 데이터인지 판단하기 위해 dct:description · csvw:tableSchema · dct:type · rai:dataLimitations · rai:dataBiases를 읽습니다.
schema = m.get("csvw:tableSchema")
if schema is None:
    return 근거없음("컬럼 의미가 기록되지 않았다")      # 컬럼명으로 추정하지 않는다
for col in 질문이_쓰는_컬럼:
    if not 컬럼(schema, col).get("dc:description"):
        return 근거없음(f"{col} 의 뜻이 기록되지 않았다")
# rai:dataLimitations · rai:dataBiases 는 사람이 쓴 문장 목록이다.
# 문자열 일치로 걸러내지 말고, 답과 함께 그대로 제시한다.
주의사항 = m.get("rai:dataLimitations", []) + m.get("rai:dataBiases", [])
return 적합(주의=주의사항)
필드가 없을 때: 컬럼 정의서(csvw:tableSchema)에 컬럼 설명이 없으면 컬럼 이름으로 뜻을 추정하지 않고, 답에 「컬럼 의미 미기록」을 밝힙니다.
신뢰성 — 신뢰 근거
신뢰할 수 있는 데이터인지 판단하기 위해 aird:lifecycleStatus · dcat:distribution[].spdx:checksum · dct:modified · dct:accrualPeriodicity · aird:diagnosticMaturity · aird:qualityTier · aird:thresholdProfile · aird:diagnosticReport를 읽습니다.
# 끝이름: 개념 URI의 마지막 부분 (…/lifecycle-status/Stale → Stale)
if 끝이름(m["aird:lifecycleStatus"]) == "Stale":
    return 제외("효력 정지 상태")
d = 배포자원(m, 내려받은_주소)                    # 체크섬은 배포 자원마다 있다
if sha256(내려받은_파일) != d["spdx:checksum"]["spdx:checksumValue"]:
    return 제외("체크섬 불일치 — 마니페스트가 가리키는 파일이 아니다")
dm = m.get("aird:diagnosticMaturity")
if dm is None:
    # null 은 두 뜻이다. 결과서의 진단 상태로 구분한다.
    if 진단상태(m) in ("SCHEMA_ONLY", "FILE_BROKEN"):
        return 제외("진단에 들어가지 못한 파일")
    return 주의("측정 완성도 미성립 — 품질 근거가 부족하다")   # 0점으로 읽지 않는다
# 등급은 운영 지침의 임계 프로파일로 판정한 값이다. 4개 조건을 모두 확인한다.
프로파일 = 임계프로파일(m.get("aird:thresholdProfile"))   # 없으면 None
지침 = 운영지침(m)                                  # 식별자 · 버전 · 주소 — 없으면 None
등급근거 = (
    dm == "DM-2"                                              # (a) 측정 완성도 DM-2
    and 프로파일 is not None
    and 프로파일["aird:profileStatus"] == "OFFICIAL"                       # (b) EXAMPLE 은 등급 근거가 아니다
    and 평가상태(m) != "PROVISIONAL"                          # (c) 잠정 평가가 아니다
    and 지침 is not None and 지침.식별자 and 지침.버전
    and 접근가능(지침.주소)                                    # (d) 공개된 운영 지침을 확인할 수 있다
)
if not 등급근거:
    return 주의(f"측정 완성도 {dm} · 등급 근거 없음", 점수=m.get("aird:qualityIndexMin"))
return 신뢰(등급=m.get("aird:qualityTier"),
            운영지침=(지침.식별자, 지침.버전),
            프로파일=(프로파일["aird:profileId"], 프로파일["aird:profileVersion"]))
필드가 없을 때: 측정 완성도(표준 용어: 진단 성숙도, DM)가 없으면 「낮음」이 아니라 「측정 근거 부족」으로 처리합니다.
품질 등급은 다음 4개 조건을 모두 충족할 때만 근거로 읽습니다.
| 조건 | 확인하는 값 |
|---|---|
| (a) 측정 완성도 | DM-2 |
| (b) 임계 프로파일(판정 기준값)의 상태 | OFFICIAL (EXAMPLE 이 아님) |
| (c) 평가 상태 | PROVISIONAL 이 아님 |
| (d) 운영 지침 | 판정에 쓴 운영 지침의 식별자·버전을 알 수 있고, 공개된 문서에 접근할 수 있음 |
조건을 하나라도 충족하지 않으면 결과를 「주의(… 등급 근거 없음)」로 두고 점수는 참고로만 읽습니다. 운영 지침의 구성과 공개 요건은 운영 지침 구성에 있습니다.
운영 지침의 확인 방법
운영 지침을 가리키는 마니페스트 속성은 표준에 아직 없으므로, 조건 (d)는 임계 프로파일 식별 정보(aird:thresholdProfile)와 등급에 병기한 운영 지침 정보로 확인합니다.
결합성 — 결합 가능성
다른 데이터와 결합할 수 있는지 판단하기 위해 dct:identifier · csvw:tableSchema.primaryKey · csvw:tableSchema.columns[].dc:description와 결과서의 D2-02 결과를 읽습니다.
a, b = 두_데이터의_결합_컬럼
# 마니페스트에는 컬럼의 코드 체계를 담는 전용 필드가 없다 (지금은 컬럼 설명 문장에만 있다).
# 값 수준 대조 결과는 결과서에 있고 마니페스트로 노출되지 않는다 — 검증된 사실 제안이 이 틈을 메운다.
ra, rb = D2_02_결과(결과서(a)), D2_02_결과(결과서(b))   # 결과서를 읽을 수 없으면 None
if ra is None or rb is None:
    return 후보("값 수준 대조 결과를 확인할 수 없다 — 이름이 같다는 것만으로 결합하지 않는다")
if ra.적용성 != "APPLIED" or rb.적용성 != "APPLIED":
    return 후보("코드표 값 대조가 이뤄지지 않았다")
if ra.코드표 != rb.코드표:
    return 제외("서로 다른 코드표로 대조했다")
return 결합(근거=[ra.일치율, rb.일치율, ra.코드표_버전])
필드가 없을 때: D2-02(참조 무결성)의 값 수준 대조 결과가 없으면 결합을 「후보」로만 두고, 결과에 결합 근거가 없음을 밝힙니다.
사용 가능성 — 이용 조건
이용해도 되는 데이터인지 판단하기 위해 dct:license · dct:rights · dct:accessRights · aird:containsPersonalData · aird:deidentificationLevel · odrl:hasPolicy를 읽습니다.
if 끝이름(m["dct:accessRights"]) != "PUBLIC":
    return 사람확인("접근 제한 데이터")
lic = m["dct:license"]
if lic not in KR_LICENSE:                      # 어휘표 kr-license 값 목록
    return 사람확인("값 목록 밖의 라이선스 — 기계가 조건을 읽을 수 없다")
조건 = 라이선스_조건(lic)
# AI 학습 허용 여부는 필수 항목이 없다 — 선택 항목 odrl:hasPolicy 만 읽고, dct:rights 문구로 추정하지 않는다
정책 = m.get("odrl:hasPolicy")
학습허용 = 정책_허용행위(정책) if 정책 else "미확인"
return 사용가능(조건=조건, 학습허용=학습허용)
필드가 없을 때: AI 학습 허용 여부는 표준의 필수 항목에 없으며, 선택 항목인 이용 정책(odrl:hasPolicy)에 담을 수 있습니다. 이용 정책이 없으면 이용 조건(dct:rights) 문구로 추정하지 않고 「미확인」으로 기록합니다.
표준에 규정이 없는 정보의 처리
다음 4가지 정보는 표준의 필수 항목에 없으므로, 이 사이트는 에이전트 측 처리 방식을 다음과 같이 권고합니다.
| 필수 항목에 없는 정보 | 에이전트 측 권고 |
|---|---|
| 시간 범위 · 공간 범위 | DCAT의 dct:temporal · dct:spatial 이 있으면 읽습니다. 없으면 「범위 미기록」으로 둡니다. 질문이 범위를 요구하면 사람의 확인으로 이관합니다. |
| AI 학습 허용 여부 | ODRL 정책(odrl:hasPolicy)이 있으면 허용 · 금지 행위를 읽습니다. 없으면 「미확인」으로 기록합니다. 학습 용도이면 사람의 확인으로 이관합니다. |
| 자동 수집 허용 여부 · 이용 조건의 버전 | ODRL 정책에 금지 행위(odrl:prohibition)가 있으면 따릅니다. 정책이 없고 이용 조건이 약관 문서뿐이면 자동으로 수집하지 않고 「미확인」으로 기록합니다. 약관의 시행일을 확인할 수 없으면 사람의 확인으로 이관합니다. |
| API 가용성 · 응답의 명세 일치 | 에이전트가 호출 전에 직접 확인합니다. 확인 시각과 결과를 판단 근거로 함께 남깁니다. 마니페스트의 값으로 대신하지 않습니다. |
참고: 마니페스트의 형태는 마니페스트 예시, 속성 목록은 기재 항목에 있습니다.
근거: 제3부
다른 갈래 · 데이터 준비 — 데이터 설명서 작성 (1단계) · 운영 지침 — 도입 판단 요약
도입 판단 요약
표준 도입을 검토하는 조직(공공기관·기업·산업 단체·데이터 플랫폼)을 위해 표준의 범위, 운영 지침, 도입 절차를 요약합니다. 이 표준은 의무가 아니며, 도입하는 조직은 1단계 기재부터 시작하고 운영 지침을 구성하거나 표준 제공 운영 지침을 채택합니다.
개요
AI 레디 데이터(AIRD) 표준은 AI 에이전트가 데이터를 활용하기 전에 내리는 4가지 판단, 즉 적합성(질문에 맞는가)·신뢰성(신뢰할 수 있는가)·결합성(결합할 수 있는가)·사용 가능성(이용해도 되는가)의 근거를 데이터와 함께 기계가 읽을 수 있는 형태로 남기는 방법을 규정합니다. 제1~3부는 TTAK 초안(0.95 버전)이고, 제4·5부는 2027년 중 제정 예정인 후속 부입니다.
도입 배경
데이터를 이용하는 주체가 사람에서 AI 에이전트로 넓어지고 있으며, 에이전트는 데이터에 기록되지 않은 사실을 확인할 수 없으므로 추정합니다. 목록 메타데이터가 비교적 충실한 공공데이터 1건을 관측한 결과, 표준 초안 기준 필수 기재 항목 19개(데이터셋 15, 배포 자원 4) 가운데 10개를 새로 작성해야 했습니다. 포털 등록과 AI 활용 준비는 별개의 작업입니다. 기업이 무료로 제공하는 데이터는 자체 이용약관으로 재배포나 자동 수집을 금지하기도 하는데, 사람은 약관을 읽고 판단하지만 에이전트는 이용 조건을 확인할 수 없습니다(필요성과 사례).
적용 의무
이 표준은 법령이나 규정에 따른 의무가 아니며, 조직 간 순위를 산정하는 방법을 규정하지 않습니다. 제1~3부 표준 초안은 2026년 12월 제정 범위이고, 제정본이 발행되면 제정본이 우선합니다. 제정 전이므로 내용이 바뀔 수 있습니다. 제4·5부는 2027년 중 제정 예정인 후속 부입니다. 제정본이 발행되면 이 사이트도 함께 갱신합니다.
주체별 할 일
| 주체 | 할 일 |
|---|---|
| 데이터 담당자 | 1단계 기재 항목과 컬럼 설명 작성 · 2단계 수정 가능한 값 수정과 한계 기록 · 3단계는 활용 목적이 정해진 데이터만 |
| 진단 도구·시스템 | 점수 계산 · 데이터 설명서(마니페스트)와 결과서(표준 용어: 진단 리포트) 초안 생성 · 체크섬 계산 |
| 운영 지침 발행 주체 | 운영 지침 구성 또는 표준 제공 운영 지침 채택 · 운영 지침과 임계 프로파일(판정 기준값) 공개 |
| 데이터를 구매·조달하는 조직 | 계약·조달 조건에 마니페스트와 기계 판독 이용 조건의 제공을 요구할 것을 권장 |
이 사이트는 활용 요청이 있는 데이터, 다른 데이터와 결합해 쓰는 데이터, 나머지 데이터 순으로 준비할 것을 권고합니다(자주 묻는 질문).
결정 사항
판정 기준은 표준과 별도의 운영 지침이 설정하므로, 도입하는 조직은 운영 지침을 직접 구성할지 표준 제공 운영 지침을 채택할지 결정합니다. 표준 제공 운영 지침은 표준 제정 시 공개하며(2026년 12월 예상), 조직·기관·도메인은 운영 지침을 독립적으로 구성할 수 있습니다. 운영 지침을 적용하지 않은 결과는 등급을 판정하지 않습니다(판정하지 않음: 운영 지침 미적용, 판정 절차).
표준과 운영 지침의 역할 분담
등급 요소(등급 체계 Tier 0~4·등급명·표기 형식·판정 절차)는 표준을 따르고, 운영 요소(임계 프로파일·진단 주기·결과 유효기간·이의제기 절차·도구 인증)는 운영 지침이 설정합니다. 운영 지침은 임계 프로파일(판정 기준값)을 포함합니다.
등급을 판정·공개하는 조직은 적용한 운영 지침을 공개해 접근 가능하게 하고, 등급에 운영 지침의 식별자·버전을 함께 기재합니다. 측정과 결과서 작성은 운영 지침 없이도 할 수 있습니다. 운영 지침의 구성과 공개 요건은 운영 지침 구성에 있습니다.
표준에 규정이 없는 정보
시간·공간 범위, AI 학습 허용 여부, API 가용성은 필수 항목에 없습니다. 기업의 자체 이용약관은 어휘표의 라이선스 값 목록(kr-license)에 없으므로 이용 조건(dct:rights)에 기재합니다(에이전트가 읽는 것).
비용과 효과
1단계는 데이터값을 변경하지 않고 설명 정보를 기재하는 단계이며, 별도 도구 없이 시작할 수 있습니다. 체크섬은 sha256sum 같은 일반 도구로 계산합니다. 기존 등록 시스템이 필수 속성 입력·버전 관리·체크섬 생성·마니페스트 발행을 지원하지 않으면 해당 기능을 추가해야 합니다.
이 사이트의 측정 엔진(시험용)은 마니페스트가 있으면 에이전트가 추정해야 하는 항목이 줄어드는 것을 보여 줍니다. 실제 에이전트의 행동과 답의 정확도에 미치는 효과는 아직 측정하지 않았으며, 효과 확인 실험은 실행 전입니다.
도입 절차
- 대상 데이터 선정과 1단계 기재 항목 작성: 데이터 파일과 기존 목록 정보로 마니페스트를 작성합니다(데이터 설명서 작성(1단계)).
- 결과서의 구성과 미측정 사유를 읽는 방법 확인(결과서 읽기)
- 운영 지침 구성 또는 표준 제공 운영 지침 채택(운영 지침 구성)
다음 단계: 운영 지침 구성
근거: 제1부 7.1
운영 지침 구성
목차
목차운영 지침은 판정 기준값과 운영 사항을 담은 문서로, 표준과 별도로 구성합니다. 등급 체계·등급명·표기 형식·판정 절차는 표준을 따르고, 판정 기준값과 운영 사항은 운영 지침이 설정합니다.
운영 지침과 표준의 역할 구분
판정에 쓰는 수치(임계 프로파일)와 진단 주기·결과 유효기간 같은 운영 사항은 운영 지침이 설정하고, 등급 체계·판정 절차·품질 지표의 정의·등급 표기 형식 같은 등급 요소는 표준이 규정합니다.
운영 요소와 등급 요소 목록
두 열은 각각의 목록이며, 같은 줄의 항목이 서로 짝을 이루지는 않습니다.
| 운영 지침이 설정하는 것 (운영 요소) | 표준이 규정하는 것 (등급 요소) |
|---|---|
| 임계 프로파일의 등급 구간 경계값 | 등급 체계 Tier 0~4와 등급명 (Unqualified · Bronze · Silver · Gold · Platinum) [제2부 7.1] |
| 임계 프로파일의 차원별 필수 통과선 · 차원 가중치 · 가중치 조정 범위 | 판정 절차: 최소 차원 점수로 후보 등급 → 통과선 확인 → 미달 차원이 있으면 한 단계 강등 [제2부 6 · 7] |
| 임계 프로파일의 DM-1 측정 충족률(평가 범위) 하한 · 지표 파라미터 (D3-02(라벨 정확성)의 라벨 일치 기준 · D5-03 더미값 패턴) | 16개 품질 지표의 정의 · 측정식 · 측정 완성도 결정표 [제2부 부속서 B.5] |
| 임계 프로파일의 식별자 · 버전 · 활성화 절차 | 임계 프로파일의 항목 구조 [제2부 부속서 D · 표 9-3] |
| 운영 사항: 진단 주기 · 결과 유효기간 · 이의제기 절차 · 도구 인증 [제1부 7.1] | 등급 표기 형식 Gold (Tier 3, STRUCT) [제1부 부속서 A] |
| 목적 등급의 판정 기준 · 팩의 세부 구조 | 준비 상태와 팩의 구성 [제1부 5.1 · 5.5] |
같은 점수, 다른 기준
같은 차원 점수도 적용한 운영 지침의 판정 기준값에 따라 품질 등급이 달라집니다. 아래 모의 계산의 기준값은 무작위로 생성되는 가상의 값이며, 이 사이트가 제시하는 기준값이 아닙니다.
운영 지침의 구성 방식
표준 제공 운영 지침은 표준 제정 시 공개합니다(2026년 12월 예상). 운영 지침 발행 주체는 하나가 아니며, 조직·기관·도메인은 운영 지침을 독립적으로 구성할 수 있습니다. 운영 지침 발행 주체는 다음 3개 방식 가운데 하나를 선택합니다.
- 채택: 표준 제공 운영 지침을 그대로 적용하고, 등급과 함께 그 운영 지침의 식별자·버전을 기재합니다.
- 조정: 표준 제공 운영 지침을 바탕으로 임계 프로파일·운영 사항을 조정하고, 조정한 운영 지침을 자체 식별자·버전으로 공개합니다.
- 자체 구성: 임계 프로파일과 운영 사항을 직접 설정하고, 운영 지침을 자체 식별자·버전으로 공개합니다.
어느 방식이든 등급 요소는 표준을 따릅니다.
임계 프로파일의 구성
임계 프로파일(판정 기준값)은 운영 지침에 포함되는 기계 판독 파일로, 등급 구간·통과선·가중치처럼 운영하면서 조정하는 수치를 식별자와 버전을 붙여 수록합니다. 식별자·버전·활성화 절차는 운영 지침이 설정하고, 항목의 구조는 제2부 부속서 D가 규정합니다. 기계 표현은 aird-threshold-profile-1.0.schema.json입니다.
임계 프로파일의 항목 — 표 10행 펼치기
| 항목 | 구분 | 값 범위 | 설정하는 수치 |
|---|---|---|---|
profileId | 필수 | URI | 프로파일 식별자 |
version | 필수 | SemVer | 프로파일 버전 |
status | 필수 | OFFICIAL 또는 EXAMPLE | 프로파일 상태 |
digest | 필수 | SHA-256 | 프로파일 파일의 해시 |
tierThresholds | 필수 | 0.0–1.0 값 4개 | 등급 구간 (제2부 7.1) |
passLines | 필수 | 7개 차원 × 4개 등급 | 차원별 필수 통과선 (7.2) |
dimensionWeights | 필수 | 합이 1.00인 7개 값 | 차원 가중치 (6.3) |
weightAdjustmentRange | 필수 | 차원별 하한 · 상한 | 가중치 조정 범위 (6.3) |
dm1Coverage | 필수 | 0.0–1.0 | DM-1 평가 범위 하한 (8.1) |
indicatorParameters | 조건부 필수 | 지표별 객체 | D3-02 이미지 라벨 일치 기준 · D5-03 더미값 패턴 |
등급 표기와 공개 요건
등급을 판정·공개하는 쪽은 다음 4가지 요건을 지킵니다.
- 표준 형식의 등급 표기: 등급은
Gold (Tier 3, STRUCT)형식으로 기재합니다. 데이터 유형은 반드시 함께 기재하고, 측정 완성도(표준 용어: 진단 성숙도, DM)는 등급 표기에서 제외합니다. - 운영 지침의 식별자·버전 병기: 판정에 적용한 운영 지침의 식별자·버전을 등급과 함께 기재합니다.
- 운영 지침과 임계 프로파일의 공개: 적용한 운영 지침과 임계 프로파일을 누구나 접근할 수 있도록 공개합니다.
- 해시 기록: 결과서(표준 용어: 진단 리포트)에 임계 프로파일의 식별자·버전·해시를 기록합니다. 데이터 이용자는 해시로 판정에 쓴 파일을 확인할 수 있습니다.
예시 임계 프로파일 (제2부 부록 Ⅰ)
예시 예시 임계 프로파일 · 상태 EXAMPLE · 등급 판정에 쓰지 않음 · 원천 TTAK 초안(0.95 버전)
제2부 부록 Ⅰ의 수치는 학술적 근거를 확정한 값이 아닙니다. 예시 임계 프로파일은 이 수치를 부속서 D의 구조로 수록한 파일로 상태가 EXAMPLE이며 잠정 계산과 도구 개발에만 사용하고 등급 판정에는 사용하지 않습니다. 아래 표의 값은 모두 예시값입니다.
등급 구간 (최소 차원 점수) — 예시
| 등급 | 등급명 | 최소 차원 점수 |
|---|---|---|
| Tier 4 | Platinum | 0.95 이상 |
| Tier 3 | Gold | 0.85 이상 0.95 미만 |
| Tier 2 | Silver | 0.70 이상 0.85 미만 |
| Tier 1 | Bronze | 0.50 이상 0.70 미만 |
| Tier 0 | Unqualified | 0.50 미만 또는 통과선 미달 |
Tier 0은 최소 차원 점수가 0.50 미만인 경우와, 후보 등급이 Tier 1이었으나 Tier 1 통과선에 미달한 차원이 있어 한 단계 강등된 경우에 성립합니다.
차원별 필수 통과선 — 예시
차원별 필수 통과선 — 표 7행 펼치기
| 차원 | Tier 1 | Tier 2 | Tier 3 | Tier 4 |
|---|---|---|---|---|
| D1 완전성 | 0.60 | 0.75 | 0.85 | 0.95 |
| D2 일관성 | 0.50 | 0.70 | 0.80 | 0.90 |
| D3 정확성 | 0.65 | 0.80 | 0.90 | 0.95 |
| D4 적시성 | 0.40 | 0.60 | 0.75 | 0.85 |
| D5 유효성 | 0.60 | 0.75 | 0.85 | 0.95 |
| D6 유일성 | 0.60 | 0.75 | 0.85 | 0.95 |
| D7 기계 판독성 | 0.80 | 0.90 | 0.95 | 1.00 |
차원 가중치 — 예시
차원 가중치 — 표 7행 펼치기
| 차원 | 예시 가중치 | 조정 범위 |
|---|---|---|
| D1 완전성 | 0.18 | 0.10 ~ 0.25 |
| D2 일관성 | 0.10 | 0.07 ~ 0.18 |
| D3 정확성 | 0.24 | 0.17 ~ 0.32 |
| D4 적시성 | 0.10 | 0.05 ~ 0.18 |
| D5 유효성 | 0.13 | 0.08 ~ 0.20 |
| D6 유일성 | 0.12 | 0.08 ~ 0.18 |
| D7 기계 판독성 | 0.13 | 0.08 ~ 0.20 |
그 밖의 수치 — 예시
| 항목 | 예시값 |
|---|---|
| DM-1 측정 충족률(평가 범위) 하한 (예시 임계 프로파일로는 DM-1을 판정하지 않음) | 0.50 |
| D3-02(라벨 정확성) 라벨 일치 기준: 이미지 겹침 비율 | 0.5 이상 |
| D5-03 더미값 패턴 | 999999, 99999999, 9999, -1, -9, 0000 |
목적별 기준
목적 등급의 판정 기준은 운영 지침이 설정합니다. 목적 등급은 활용 목적 유형마다 등록 상태(Registered)의 운용 계층 프로파일이 있을 때 판정하며, 등록 상태 프로파일이 없는 유형은 목적 등급을 판정하지 않습니다(PROFILE_NOT_REGISTERED). 이 경우 목적에 맞게 준비된 데이터(Purpose-Ready)도 성립하지 않습니다. 프로파일 상태는 Draft·Candidate·Registered·Deprecated의 4가지입니다.
운영 지침 적용 전의 측정
측정과 결과서 작성은 운영 지침 없이도 할 수 있습니다. 이 경우 진단 도구는 D5-03(통계적 타당성)을 제2부 부록 Ⅰ의 예시 패턴으로 잠정 측정하고 평가 상태를 PROVISIONAL로 기재하며, 결과의 등급은 판정하지 않습니다(판정하지 않음: 운영 지침 미적용).
운영 지침 적용 후의 재측정 조건
운영 지침을 적용한 뒤 D5-03 패턴이 예시와 다르면 다시 측정하고 새 결과서를 발행합니다. 기존 결과서는 측정 대상 버전·측정 규칙·임계 프로파일·측정 시점이 모두 같을 때만 그대로 사용합니다.
측정 완성도와 등급 판정 단계는 판정 절차에 있습니다.
근거: 제1부 3.20, 3.21, 5.1, 5.5, 5.6 표 5-3, 7.1, 부속서 A · 제2부 6, 7.1, 7.3, 9.1, 표 9-3, 부속서 B.5, 부속서 D 표 D.1, 부록 Ⅰ 표 Ⅰ.1~Ⅰ.4 · 제3부 8.2, 부속서 C.19
핵심 개념
준비 상태와 확인 지점, 3가지 판정, 산출물, 역할 등 표준을 읽는 데 필요한 개념 4개 묶음을 정의합니다. 측정 완성도·품질 등급·목적 등급은 서로 다른 질문에 답하므로 합산하지 않고 따로 기록합니다.
준비 상태와 확인 지점
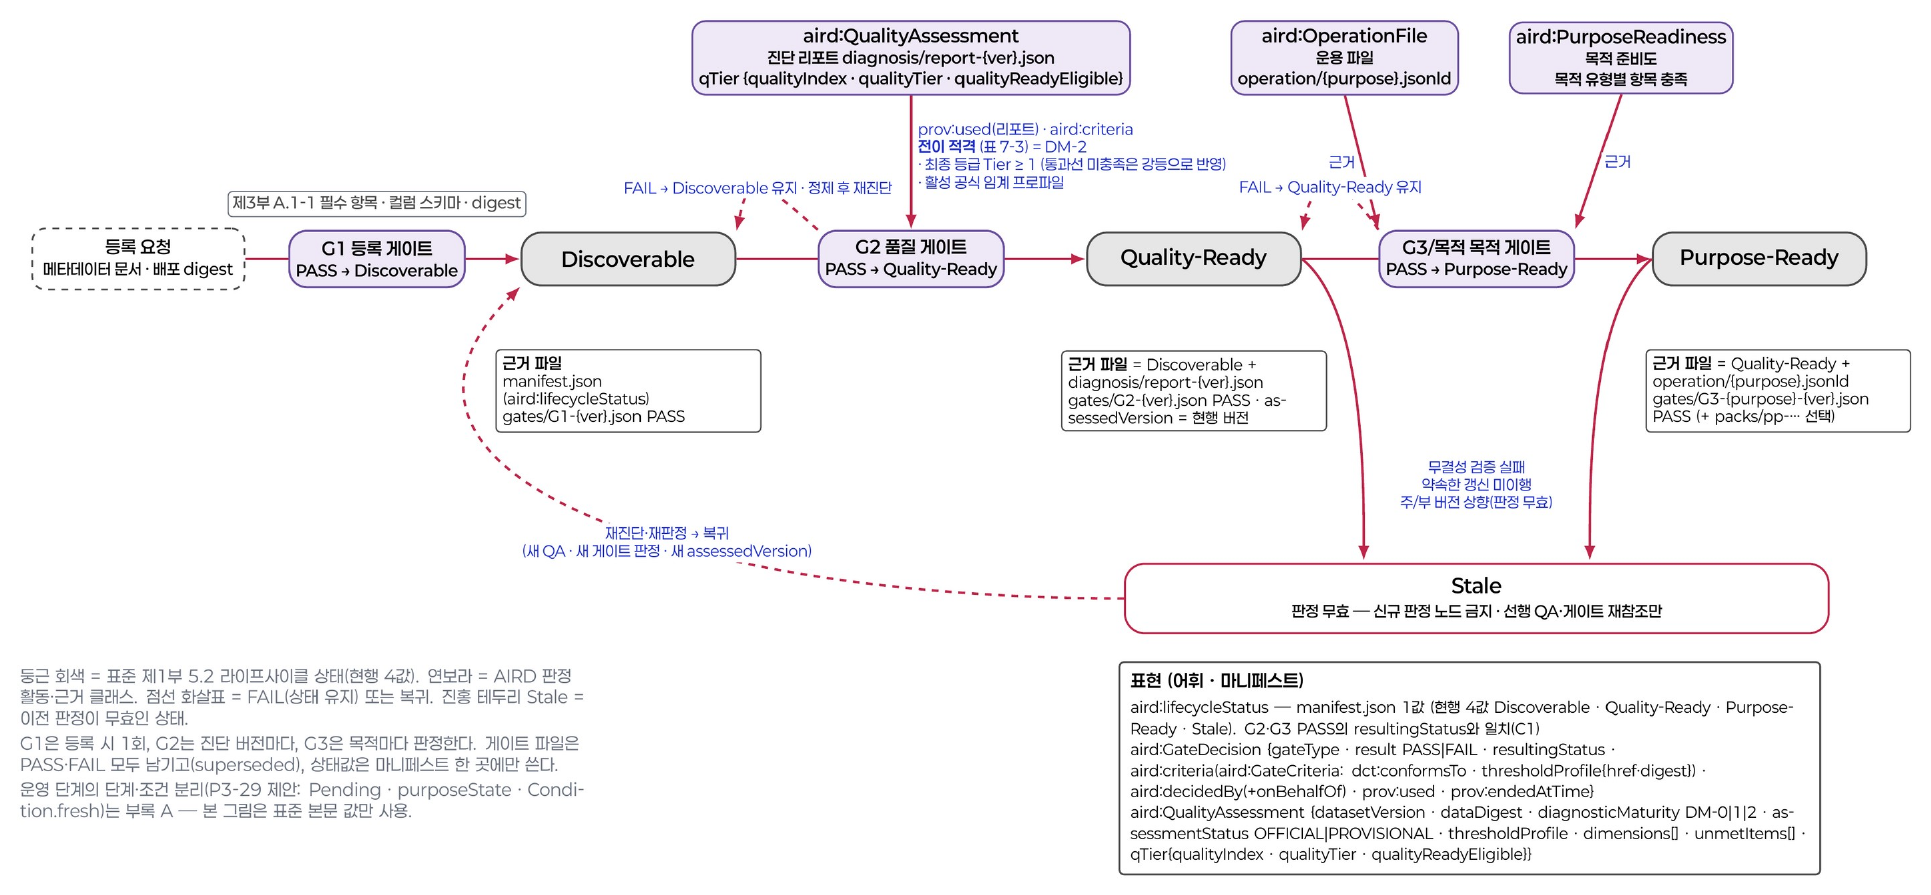
데이터는 3개 단계를 거쳐 준비되며, 각 단계의 끝에 있는 확인 지점(표준 용어: 결정 게이트, G1·G2·G3)에서 다음 준비 상태로 전이할 수 있는지 판정합니다. 확인 지점 G1·G2·G3를 통과하면 각각 찾을 수 있는 데이터(Discoverable), 품질이 확인된 데이터(Quality-Ready), 목적에 맞게 준비된 데이터(Purpose-Ready)가 되며, G2는 측정 완성도 DM-2·운영 지침 적용·품질 등급 Tier 1 이상을 모두 요구합니다. AI 레디 데이터는 AI 활용을 위한 공통 준비 요건을 충족한 Quality-Ready 또는 Purpose-Ready 상태의 데이터입니다.
확인 지점을 통과하지 못한 데이터는 탈락하지 않고, 보완한 뒤 다시 확인합니다. 도달한 상태도 갱신 지연이나 체크섬 불일치가 생기면 효력이 정지된 상태(Stale)가 되며, 갱신하고 재검증하면 복귀합니다. Quality-Ready 전이 조건의 세부는 판정 절차에 있습니다.
준비 상태별 조건과 용어
| 풀이어 | 표준 용어 | 해설 |
|---|---|---|
| 찾을 수 있는 데이터 | 디스커버러블 Discoverable | 발견 계층의 필수 기재 항목을 갖춘 상태. 1단계의 결과. |
| 품질이 확인된 데이터 | 퀄리티 레디 Quality-Ready | 품질을 측정하고 G2에서 전이 조건(DM-2 · Tier 1 이상 · 운영 지침 적용)을 충족한 상태. 2단계의 결과. |
| 목적에 맞게 준비된 데이터 | 펄포즈 레디 Purpose-Ready | 특정 활용 목적의 기준에 맞춰 준비된 상태. 3단계의 결과. |
| 효력 정지 상태 | 스테일 Stale | 갱신 지연이나 체크섬 불일치로 준비 상태의 효력이 정지된 상태. 갱신하고 재검증하면 복귀. |
| 확인 지점 | 결정 게이트 Decision Gate (G1 · G2 · G3) | 각 단계의 끝에서 다음 상태로 전이할 수 있는지 판정하는 지점. |
- 하는 일
- 원천에서 제공된 직후의 데이터입니다. 이 상태의 데이터는 AI 레디 데이터가 아닙니다.
- 검증된 계층
- 없음
- 품질 등급
- —
- 목적 등급
- —
- 측정 완성도
- —
- 원시 데이터 관계
- 원시 데이터셋
- 하는 일
- 내용과 소재가 기록되어 검색과 접근이 가능한 상태입니다.
- 검증된 계층
- 발견
- 품질 등급
- —
- 목적 등급
- —
- 측정 완성도
- 측정했다면 DM-0 · DM-1 · DM-2
- 원시 데이터 관계
- 원시 데이터셋의 값을 유지 · 필요하면 형식만 변환
- 진입 경로
- 1단계 — 수집 · 개방 형식 변환 · 발견 계층 작성
- G1 판정 대상
- 발견 계층의 완비
- 상태 증명 파일
- manifest.json (발견 계층) · G1 판정 기록
- 하는 일
- 품질을 측정하고 운영 지침으로 판정해 전이 조건을 충족한 상태입니다. 공통 준비 요건을 충족하면 AI 레디 데이터입니다.
- 검증된 계층
- 발견 · 이해
- 품질 등급
- Tier 1(Bronze) 이상
- 목적 등급
- —
- 측정 완성도
- DM-2
- 원시 데이터 관계
- 정제 결과를 반영 · 원시와 같은 데이터셋
- 진입 경로
- 2단계 — 품질 측정 · 결함 수정 · 이해 계층 작성
- G2 판정 대상
- Quality-Ready 전이 가능 여부 (DM-2 · Tier 1 이상 · 운영 지침의 임계 프로파일 적용)
- 상태 증명 파일
- manifest.json (발견 · 이해 계층) · 결과서 · G2 판정 기록
- 하는 일
- 특정 활용 목적의 정량 요건까지 충족한 상태입니다.
- 검증된 계층
- 발견 · 이해 · 운용
- 품질 등급
- 유지
- 목적 등급
- 목적별 부여
- 측정 완성도
- DM-2
- 원시 데이터 관계
- 목적별 파생물 · 원시와 함께 존재
- 진입 경로
- 3단계 — 목적별 변환 · 운용 계층 작성
- G3 판정 대상
- 목적 요건의 충족
- 상태 증명 파일
- manifest.json · 결과서 · 운용 파일 (목적별) · G3 판정 기록
- 하는 일
- 체크섬이 일치하지 않거나 기재한 갱신 주기를 지키지 않아, 부여된 등급의 효력이 정지된 상태입니다. 재검증을 통과하면 직전 상태로 복귀합니다.
- 검증된 계층
- 직전 상태 유지
- 품질 등급
- 효력 정지
- 목적 등급
- 효력 정지
- 측정 완성도
- 유지
- 원시 데이터 관계
- 직전 상태의 관계 유지
3가지 판정 — 합산하지 않습니다
품질 판정은 3개 값으로 나뉘며, 값마다 답하는 질문과 결정 근거가 다르므로 진단 도구는 3개 결과를 따로 기록합니다. 측정 완성도(표준 용어: 진단 성숙도, DM)는 요구된 지표를 어디까지 측정했는지를 DM-0·DM-1·DM-2로 나타내며, 결정표로 결정합니다. 품질 등급(Q-Tier)은 측정한 품질의 수준을 Tier 0~4로 나타내며, 최소 차원 점수와 운영 지침의 임계 프로파일로 판정합니다. 목적 등급(P-Tier)은 특정 목적에 맞춘 준비 수준이며, 그 목적에 등록된 목적 프로파일로 결정합니다.
측정 점수가 높아도 측정 완성도가 DM-2가 아니면 품질 등급을 판정하지 않으며, 두 값은 서로 대체할 수 없습니다. 판정할 수 없으면 진단 도구는 「판정하지 않음」과 사유를 기록하고, 0점이나 최하 등급으로 대체하지 않습니다(상태값과 판정값).
3가지 판정 비교
| 판정 | 답하는 질문 | 형태 | 결정 근거 |
|---|---|---|---|
| 품질 등급 (Q-Tier) | 측정한 품질의 수준 | Tier 0~4 · 예: Gold (Tier 3, STRUCT) | 최소 차원 점수 · 운영 지침의 임계 프로파일 |
| 측정 완성도 (표준 용어: 진단 성숙도, DM) | 요구된 지표의 측정 범위 | DM-0 · DM-1 · DM-2 | 측정 완성도 결정표 (판정 절차) |
| 목적 등급 (P-Tier) | 특정 목적에 맞춘 준비 수준 | 예: P-Tier 2 (KG) | 그 목적에 등록된 목적 프로파일 |
품질 판정 용어
| 풀이어 | 표준 용어 | 해설 |
|---|---|---|
| 7개 차원 | 품질 차원 Quality Dimension (D1~D7) | 완전성 · 일관성 · 정확성 · 적시성 · 유효성 · 유일성 · 기계 판독성. |
| 품질 등급 | 품질 등급 Q-Tier (aird:qualityTier, Tier 0~4) | 운영 지침의 임계 프로파일로 판정하는 품질 수준. 운영 지침을 적용하지 않으면 판정하지 않음. |
| 측정 완성도 | 진단 성숙도 Diagnostic Maturity (DM-0 · DM-1 · DM-2) | 요구된 지표를 어디까지 측정했는지를 결정표로 결정하는 등급형 판정. 품질 점수와 합산하지 않음. |
| 측정 충족률 | 평가 범위 Evaluation Coverage | 적용 대상 정식 필수 지표의 statusFactor 합을 지표 수로 나눈 0~1의 값. DM-1 판정에 쓰임. |
| 최소 측정 지표 | 최소 측정 가능 지표 Minimum Measurable Indicator (MMI) | 진단의 진입 요건이 되는 지표 4종(D5-03 · D6-01 · D7-01 · D7-02). 입력 요구 수준이 가장 낮은 지표. |
| 가장 낮은 점수 | 최소 차원 점수 Minimum Dimension Score | 7개 차원 점수 가운데 가장 낮은 값. 후보 등급을 찾는 출발점. 평균은 등급 판정에 쓰지 않음. |
| 한 단계 하향 | 강등 Demotion | 운영 지침의 임계 프로파일이 설정한 차원별 필수 통과선에 미달한 차원이 있어, 후보 등급에서 한 단계 내리는 것. |
| 다음 단계 전이 가능 여부 | 전이 적격성 Transition Eligibility | 측정 완성도 DM-2와, 운영 지침 기준으로 판정한 Tier 1 이상의 품질 등급을 모두 갖춘 상태. |
산출물
판정 결과는 데이터와 별도의 문서로 남습니다. 데이터 설명서(표준 용어: 마니페스트)는 데이터셋을 기계가 읽을 수 있게 기술한 문서로, 버전마다 새로 발행하고 이전 버전을 가리킵니다. 결과서(표준 용어: 진단 리포트)는 측정할 때마다 새로 만드는 품질 측정 문서(JSON)이며, 운용 파일은 활용 목적 유형마다 하나씩 만드는 준비 산출물입니다.
배포 단위는 팩입니다. Quality-Ready 팩은 마니페스트·결과서·팩 마니페스트로 구성하고, Purpose-Ready 팩은 여기에 운용 파일을 더합니다. 데이터 파일은 팩에 넣지 않고 마니페스트가 주소와 SHA-256 체크섬으로 가리킵니다. 세부 구조는 운영 지침이 정하며, 팩 구성과 배포에서 설명합니다.
역할
작업은 3개 주체가 나누어 맡습니다. 담당자는 자료를 준비·확인하고, 수정할 수 있는 값은 수정하며, 수정할 수 없는 한계는 기록합니다. 진단 도구는 점수를 계산하고 운영 지침의 임계 프로파일에 따라 등급을 계산하며, 결과서와 마니페스트 초안을 작성하고 체크섬을 계산합니다. 운영 지침 발행 주체는 운영 지침과 임계 프로파일을 구성·공개·갱신하고, 적용한 운영 지침에 따른 등급과 전이 판정을 공개합니다. 판정 기준값은 담당자나 진단 도구가 결정하지 않습니다.
운영 지침 발행 주체는 하나가 아닙니다. 표준은 표준 제공 운영 지침을 제정 시 공개하고(2026년 12월 예상), 조직·기관·도메인은 운영 지침을 독립적으로 구성할 수 있습니다. 단계별 분담은 각 가이드 페이지의 작업 흐름(예: 품질 측정과 결과서 (2단계))에 있습니다.
주체별 업무 분담
| 주체 | 하는 일 | 하지 않는 일 |
|---|---|---|
| 담당자 | 자료 준비와 확인 · 수정할 수 있는 값의 수정 · 수정할 수 없는 한계의 기록 | 점수 계산 · 등급 계산 · 판정 기준값 결정 |
| 진단 도구 | 점수 계산 · 운영 지침의 임계 프로파일에 따른 등급 계산 · 결과서와 마니페스트 초안 작성 · 체크섬 계산 | 판정 기준값 결정 · 한계 판단 |
| 운영 지침 발행 주체 (표준 제공 운영 지침 · 조직 · 기관 · 도메인) | 운영 지침과 임계 프로파일의 구성 · 공개 · 갱신 · 적용한 운영 지침에 따른 등급과 전이 판정의 공개 | 데이터 작성 · 값 수정 |
다음 단계: 판정 절차
근거: 제1부 3.1, 3.15, 5.1, 5.2, 5.5 · 제2부 5.2, 6.2, 7.1, 7.3, 7.5, 8.1, 9, 부속서 A.2, A.3, B.5 · 제3부 5.1, 8, C.6
판정 절차
측정 완성도와 품질 등급을 판정하는 규칙을 설명합니다. 계산은 진단 도구가 하고 판정 기준은 표준과 별도의 운영 지침이 설정하므로, 담당자가 이 절차를 직접 수행하지는 않습니다.
측정 완성도 결정표
측정 완성도(표준 용어: 진단 성숙도, DM)는 요구된 지표를 어디까지 측정했는지를 나타냅니다. 진단 도구는 아래 표를 위에서부터 적용하고, 처음 충족한 줄에서 판정을 끝냅니다.
| 순서 | 조건 | 판정 |
|---|---|---|
| 1 | 진단 상태 예외: SCHEMA_ONLY(빈 파일) 또는 FILE_BROKEN(손상 파일) | 판정하지 않음 |
| 2 | 적용 대상 정식 필수 지표가 모두 APPLIED | DM-2 |
| 3 | 적용되는 최소 측정 지표(MMI)가 모두 APPLIED · 측정 충족률이 운영 지침의 하한 이상 | DM-1 |
| 4 | 적용되는 MMI가 모두 APPLIED | DM-0 |
| 5 | 그 밖의 경우 | DM-0 미성립 |
MMI는 D5-03·D6-01·D7-01·D7-02의 4종이며, 데이터 유형에 적용되는 것만 셉니다. 정식 필수 지표 가운데 부분 측정(PARTIALLY_APPLIED)이 하나라도 있으면 DM-2는 성립하지 않습니다.
측정 충족률(평가 범위)
측정 충족률(표준 용어: 평가 범위)은 DM-1 판정에 쓰는 0~1의 값으로, 다음 식으로 계산합니다.
Σ statusFactor(적용 대상 정식 필수 지표) / n(NOT_APPLICABLE 을 제외한 정식 필수 지표)
statusFactor는 지표의 적용성 상태마다 정해진 값이며(상태값과 판정값의 지표 적용성 표), 분모에서는 NOT_APPLICABLE 지표를 제외합니다. DM-1의 기준이 되는 하한은 운영 지침의 임계 프로파일(판정 기준값)이 설정합니다.
측정 충족률 계산 예시
예시 STRUCT(표 형태) 데이터의 정식 필수 지표는 13개입니다. 그 가운데 1개가 NOT_APPLICABLE이면 분모는 12입니다. statusFactor 합이 7이면(예: APPLIED 7개, 나머지 PRECONDITION_UNMET) 측정 충족률은 7/12 ≈ 0.58입니다. DM-1 성립 여부는 이 값을 운영 지침의 하한과 비교해 판정합니다.
운영 지침이 없을 때의 측정
운영 지침이 없어도 측정은 성립합니다. D5-03(통계적 타당성)은 더미값 패턴을 운영 지침의 임계 프로파일에서 받으므로, 운영 지침이 없으면 진단 도구는 제2부 부록 Ⅰ의 예시 패턴으로 D5-03을 잠정 측정하고 평가 상태를 PROVISIONAL로 기재합니다. D6-01(유일성)은 전제 조건이 없어, 식별 컬럼이 없으면 전체 컬럼 조합으로 완전 동일 레코드를 집계합니다. 따라서 파일만으로 MMI 4종을 모두 측정할 수 있고, 결정표 4행의 DM-0이 성립합니다.
DM-1은 운영 지침의 측정 충족률 하한이 있어야 판정하므로, 운영 지침이 없으면 판정하지 않습니다. 품질 등급도 운영 지침을 적용해야 판정합니다. 표준 제공 운영 지침은 표준 제정 시 공개할 예정이며(2026년 12월 예상), 조직·기관·도메인은 자체 운영 지침을 구성해 판정할 수 있습니다. 예시 임계 프로파일(부록 Ⅰ)의 상태는 EXAMPLE이며, 잠정 계산과 도구 개발에 쓰고 등급 판정에는 쓰지 않습니다.
유형별 도달 범위
운영 지침이 없을 때 데이터 유형별로 도달하는 측정 완성도는 아래와 같습니다. 이때 품질 등급은 측정 완성도와 관계없이 「판정하지 않음: 운영 지침 미적용」이며, 측정 충족률 하한이 없으므로 DM-1은 어느 유형에서도 판정하지 않습니다.
| 데이터 유형 | 정식 필수 지표 수 | 운영 지침이 없을 때의 측정 완성도 | 이유 |
|---|---|---|---|
STRUCT 표 형태 | 13 | 적어도 DM-0(잠정) | MMI 4종 측정으로 4행 충족. 예제는 외부 자료가 없어 정식 필수 지표 일부 미측정 |
TSERIES 시계열 | 13 | 적어도 DM-0(잠정) | MMI 4종 측정으로 4행 충족. 예제는 외부 자료가 없어 정식 필수 지표 일부 미측정 |
TEXT 문서 | 5 | DM-2(정식 필수 5개를 모두 측정한 경우) | 정식 필수 지표 5개가 모두 APPLIED이면 결정표 2행 충족 |
PT 지시문 · 응답 쌍 | 8 | DM-0 | D3-02(라벨 정확성)에 전문가 검수 결과 필요 |
IMAGE 이미지 | 3 | DM-0 | D3-02(라벨 정확성)에 전문가 검수 결과 필요 |
등급 판정 단계
진단 도구는 먼저 두 전제를 확인하고, 충족하지 못하면 등급을 판정하지 않고 아래 사유를 기록합니다.
| 전제 | 충족하지 못할 때의 기록 |
|---|---|
| 운영 지침 적용 | 판정하지 않음: 운영 지침 미적용 |
| 측정 완성도 DM-2 | 판정하지 않음: DM-2 미달 |
두 전제를 충족하면 가장 낮은 차원 점수에서 후보 등급을 결정하고, 통과선에 미달한 차원이 있으면 한 단계 강등합니다.
- 최소 차원 점수 확인: 결과서의 7개 차원 점수 가운데 가장 낮은 값을 찾습니다.
- 후보 등급 결정: 최소 차원 점수가 속한 임계 프로파일의 등급 구간을 후보 등급으로 합니다.
- 차원별 필수 통과선 확인: 7개 차원 점수를 임계 프로파일의 차원별 필수 통과선과 비교해 미달 차원을 찾습니다.
- 강등: 미달 차원이 있으면 후보 등급을 한 단계 내리고 강등 사유를 기록합니다.
- 확정 등급 기록: 확정 등급(예:
Gold (Tier 3, STRUCT))과 적용한 운영 지침의 식별자·버전을 기록합니다.
평균(단순 평균·가중 평균)은 등급 판정에 쓰지 않습니다. 등급 구간과 차원별 필수 통과선은 운영 지침의 임계 프로파일이 설정하며, 그 항목은 운영 지침 구성에 있습니다. 등급명은 Tier 0 Unqualified, Tier 1 Bronze, Tier 2 Silver, Tier 3 Gold, Tier 4 Platinum입니다.
Quality-Ready 전이 조건
확인 지점 G2에서 다음 조건을 모두 충족하면 데이터는 Quality-Ready(품질이 확인된 데이터) 상태로 전이합니다. 상태와 확인 지점의 정의는 핵심 개념에 있습니다.
- 측정 완성도 DM-2
- 품질 등급 Tier 1 이상
- 운영 지침의 임계 프로파일 적용
- 확인 지점 G2에서 전이 판정
등급 표기
| 구분 | 형식 | 예 |
|---|---|---|
| 품질 등급 | <등급명> (Tier N, <데이터 유형>[, 부가 상태]) | Gold (Tier 3, STRUCT) |
| 목적 등급 | P-Tier N (<활용 목적 유형>) | P-Tier 2 (KG) |
품질 등급에는 등급명과 함께 데이터 유형을 반드시 병기하고, 목적 등급에는 P- 접두어를 붙입니다. 측정 완성도(DM)는 등급 라벨에 넣지 않고 결과서의 별도 항목에 기록하며, 등급에는 적용한 운영 지침의 식별자·버전을 함께 기재합니다.
근거: 제1부 7.1, 부속서 A · 제2부 5.1, 6, 6.2, 7, 7.3, 7.5, 부속서 A.3, A.4.1, B.5 표 B.4, 부록 Ⅰ
용어집
표준 용어와 이 사이트의 풀이어를 짝지은 조회표입니다. 해설은 규범적 정의가 아니며, 규범적 정의는 각 부의 「용어 정의」 장을 따릅니다.
준비 상태와 확인 지점
| 표준 용어 | 풀이어 | 해설 | 근거 |
|---|---|---|---|
| AI 레디 데이터 AI-Ready Data · 약칭 AIRD | AI 레디 데이터 (AIRD, 에어드) | AI 활용을 위한 공통 준비 요건을 충족한 Quality-Ready(품질이 확인된) 또는 Purpose-Ready(목적에 맞게 준비된) 상태의 데이터. 약칭 AIRD는 「에어드」로 읽습니다. | [제1부 3.1] |
| 디스커버러블 Discoverable | 찾을 수 있는 데이터 | 발견 계층의 필수 기재 항목을 갖춘 상태. 1단계의 결과입니다. | [제1부 5.2] |
| 퀄리티 레디 Quality-Ready | 품질이 확인된 데이터 | 측정 완성도 DM-2와 운영 지침으로 판정한 등급 Tier 1 이상을 갖춘 상태. 2단계의 결과입니다. | [제1부 5.2] |
| 펄포즈 레디 Purpose-Ready | 목적에 맞게 준비된 데이터 | 특정 활용 목적의 기준에 맞춰 준비된 상태. 3단계의 결과입니다. | [제1부 5.2] |
| 스테일 Stale | 효력 정지 상태 | 갱신 지연이나 체크섬 불일치로 준비 상태의 효력이 정지된 상태. 갱신하고 재검증하면 복귀합니다. | [제1부 5.2] |
| 결정 게이트 Decision Gate (G1 · G2 · G3) | 확인 지점 | 각 단계의 끝에서 다음 상태로 전이할 수 있는지 판정하는 지점. | [제1부 5.2] |
산출물
| 표준 용어 | 풀이어 | 해설 | 근거 |
|---|---|---|---|
| 마니페스트 Manifest | 데이터 설명서 | 데이터셋을 기계가 읽을 수 있게 기술한 문서. 버전마다 새로 발행하고 이전 버전을 가리킵니다. | [제3부] |
| 진단 리포트 Diagnostic Report | 결과서 | 측정할 때마다 새로 만드는 JSON 문서. 이 사이트에서는 「결과서」로 부릅니다. | [제2부 9] |
| 운용 파일 Operation File | 목적별 운용 파일 | 활용 목적마다 따로 만드는 준비 산출물. | [제3부 8] |
| 팩 Pack | 묶음 | 배포 단위. Quality-Ready 팩은 마니페스트 · 결과서 · 팩 마니페스트로 이루어지고, Purpose-Ready 팩은 운용 파일을 더합니다. 데이터 파일은 팩에 넣지 않고 주소와 SHA-256 체크섬으로 가리킵니다. | [제1부 3.15 · 5.5 · 제3부 5.1] |
품질 판정
| 표준 용어 | 풀이어 | 해설 | 근거 |
|---|---|---|---|
| 품질 차원 Quality Dimension (D1~D7) | 7개 차원 | 완전성 · 일관성 · 정확성 · 적시성 · 유효성 · 유일성 · 기계 판독성. | [제2부 5.2] |
| 품질 등급 Q-Tier (aird:qualityTier, Tier 0~4) | 품질 등급 | 운영 지침의 임계 프로파일로 판정하는 품질 수준. 운영 지침을 적용하지 않으면 판정하지 않습니다. | [제2부 7.1 · 제3부 C.6] |
| 진단 성숙도 Diagnostic Maturity (DM-0 · DM-1 · DM-2) | 측정 완성도 | 요구된 지표를 어디까지 측정했는지를 결정표로 결정하는 등급형 판정. 품질 점수와 합산하지 않습니다. | [제2부 8.1 · 부속서 B.5] |
| 측정 완성도 결정표 표 B.4 | 결정표 | 측정 완성도를 결정하는 5줄의 표. 위에서부터 처음 충족한 줄이 결과입니다. 표 전체는 판정 절차에 있습니다. | [제2부 부속서 B.5 표 B.4] |
| 평가 범위 Evaluation Coverage | 측정 충족률 | 적용 대상 정식 필수 지표의 statusFactor 합을 지표 수로 나눈 0~1의 값. DM-1 판정에서 운영 지침의 하한과 비교합니다. | [제2부 부속서 A.3 · B.5] |
| 최소 측정 가능 지표 Minimum Measurable Indicator (MMI) | 최소 측정 지표 | 진단의 진입 요건이 되는 지표 4종(D5-03 · D6-01 · D7-01 · D7-02). 입력 요구 수준이 가장 낮은 지표입니다. 데이터 유형에 적용되는 것만 측정합니다. | [제2부 부속서 A.2] |
| 최소 차원 점수 Minimum Dimension Score | 가장 낮은 점수 | 7개 차원 점수 가운데 가장 낮은 값. 후보 등급을 찾는 출발점입니다. 평균은 등급 판정에 쓰지 않습니다. | [제2부 6.2] |
| 강등 Demotion | 한 단계 하향 | 임계 프로파일의 차원별 필수 통과선에 미달한 차원이 있어 후보 등급에서 한 단계 내려가는 것. | [제2부 7.3] |
| 전이 적격성 Transition Eligibility | 다음 단계 전이 가능 여부 | 측정 완성도 DM-2와 운영 지침으로 판정한 Tier 1 이상의 등급을 모두 갖춘 상태. | [제2부 7.5] |
활용 목적
| 표준 용어 | 풀이어 | 해설 | 근거 |
|---|---|---|---|
| 목적 등급 P-Tier (aird:purposeTier, P-Tier 1~3) | 목적 등급 | 활용 목적별로 등록된 기준에 따라 판정하는 준비 수준. | [제3부 C.7] |
운영 지침
| 표준 용어 | 풀이어 | 해설 | 근거 |
|---|---|---|---|
| 운영 지침 | 판정 기준을 담은 문서 | 판정 기준을 담은 문서. 표준이 제공하고 조직 · 기관 · 도메인이 독립적으로 구성할 수 있습니다. 표준 제공 운영 지침은 표준 제정 시 공개합니다(2026년 12월 예상). 임계 프로파일과 운영 사항(진단 주기 · 결과 유효기간 · 이의제기 절차 · 도구 인증)을 담습니다. | [제1부 7.1] |
| 임계 프로파일 Threshold Profile | 판정 기준값 | 가중치 · 등급 구간 · 통과선 · 하한 · 지표 파라미터를 설정한 값. 운영 지침에 포함됩니다. 상태는 OFFICIAL 또는 EXAMPLE이며, EXAMPLE은 등급 판정에 쓰지 않습니다. | [제2부 부속서 D · 표 9-3] |
| 운영 지침 발행 주체 | 운영 지침을 구성 · 발행하는 조직 | 운영 지침을 구성하고 발행하는 조직 · 기관 · 도메인. 발행 주체는 하나가 아닙니다. 등급을 판정 · 공개하는 쪽은 적용한 운영 지침을 공개하고, 등급에 운영 지침의 식별자 · 버전을 함께 적습니다. | — |
| 등록 상태 프로파일 Registered Profile | 목적별 기준 | 활용 목적마다 등록되는 판정 기준. 등록되기 전에는 목적 등급을 판정하지 않습니다. | [제3부 8.2] |
표준 문서
| 표준 용어 | 풀이어 | 해설 | 근거 |
|---|---|---|---|
| 표준 초안 TTAK 초안 · 0.95 버전 | TTAK 초안(0.95 버전) | 제1부 「개요 및 프레임워크」 · 제2부 「품질 측정·등급화」 · 제3부 「데이터셋 기술 스키마 및 응용 프로파일」의 표준 초안. 2026-05-13 제1~5부를 TTA에 표준으로 제안했으며, 심의는 TTA 정기 회의에서 진행 중입니다. 필수 요소 중심으로 기술합니다. | — |
| 어휘표 AIRD 어휘표 v0.10.5 | AIRD 어휘표 v0.10.5 | 외부 어휘를 포함한 전체 항목 목록. 표준 초안과 일치하며, 표준 초안은 필수 요소 중심이고 어휘표는 전체 목록입니다. | — |
데이터 유형
| 표준 용어 | 풀이어 | 해설 | 근거 |
|---|---|---|---|
| 정형 STRUCT | 표 형태 | 행과 열이 있고 컬럼마다 자료형이 정해진 데이터 | [제1부 5.6 표 5-5] |
| 시계열 TSERIES | 시계열 | 시간 순서로 값을 기록한 데이터. 표 형태의 특수한 경우 | [제1부 5.6 표 5-5] |
| 텍스트 TEXT | 문서 | 자연어 문장과 문서로 된 데이터 | [제1부 5.6 표 5-5] |
| 이미지 IMAGE | 이미지 | 이미지 파일(예: 사진 · 도면) | [제1부 5.6 표 5-5] |
| 페어형 텍스트 PT (Paired Text) | 지시문 · 응답 쌍 | 지시문과 응답의 쌍 또는 선호 쌍으로 이루어진 텍스트 데이터 | [제1부 5.6 표 5-5 (표준 초안)] |
발행 주체와 제공 방식 (사이트 분류)
| 표준 용어 | 풀이어 | 해설 | 근거 |
|---|---|---|---|
| 공공 데이터 publisher_sector: public | 공공기관이 발행한 데이터 | 「공공데이터법」상 공공기관이 발행하거나 제공하는 데이터. 데이터가 다루는 주제가 아니라 발행 주체로 나눕니다. 표준의 대상 가운데 하나입니다 | — |
| 기업 데이터 publisher_sector: enterprise | 기업이 발행한 데이터 | 기업이 만들거나 제공하는 데이터. 기업이 만들고 공공 플랫폼이 공개하면 만든 주체(dct:creator, 기업)로 분류합니다 | — |
| 민간 비영리 데이터 publisher_sector: nonprofit | 협회 · 재단 · 커뮤니티의 데이터 | 산업 협회 · 재단 · 커뮤니티가 발행하는 데이터 | — |
| 개방 provision_mode: open_license | 오픈 라이선스로 개방 | 표준 라이선스 값(예: 공공누리 · CC)으로 이용 조건을 밝힌 제공. 기계가 이용 조건을 읽을 수 있습니다 | — |
| 무료 제공 provision_mode: free_access | 무료지만 자체 약관 | 비용은 없으나 자체 이용약관을 따릅니다. 약관이 재배포나 자동 수집을 제한할 수 있고, 기계가 이용 조건을 읽을 수 없습니다. 개방과 다릅니다 | — |
| 유상 제공 provision_mode: commercial | 계약 · 판매 | 계약 · 종량제 · 거래소 판매로 제공합니다. 가격은 dcatkr:fee · sc:offers 로 적습니다 | [어휘표 1.4.5 · 1.4.6] |
등급 표기 규칙
| 구분 | 형식 | 예 |
|---|---|---|
| 품질 등급 | <등급명> (Tier N, <데이터 유형>[, 부가 상태]) | Gold (Tier 3, STRUCT) |
| 목적 등급 | P-Tier N (<활용 목적 유형>) | P-Tier 2 (KG) |
품질 등급의 등급명은 Tier 0 Unqualified · Tier 1 Bronze · Tier 2 Silver · Tier 3 Gold · Tier 4 Platinum입니다. 등급 라벨은 다음 규칙에 따라 기재합니다.
- 등급명에는 데이터 유형을 반드시 병기합니다.
- 목적 등급에는 P- 접두어를 반드시 붙입니다.
- 측정 완성도(DM)는 등급 라벨에 넣지 않고 결과서의 별도 항목에 기록합니다.
- 적용한 운영 지침의 식별자 · 버전은 라벨 형식 밖, 등급 라벨 옆에 함께 기재합니다(예: Gold (Tier 3, STRUCT) · 운영 지침 example-guideline 1.0).
근거: 제1부 부속서 A(등급 표기 규칙) · 용어별 조항은 각 표의 근거 열
기재 항목
데이터 설명서(마니페스트)에 기재하는 항목의 조회표입니다. 발견 계층 필수 기재 항목은 23개(데이터셋 19 + 배포 자원 4)이며, 배포 자원 항목은 파일마다 기재합니다.
23개는 AIRD 어휘표 v0.10.5 데모 프로파일 기준이며, 표준 초안 필수 19개(데이터셋 15 + 배포 자원 4)에 데이터셋 구조 유형 · 주제 분류 · 랜딩 페이지 · 관리 부서 4개를 더한 것입니다. 주제 분류와 랜딩 페이지는 공공데이터에서 필수이고, 그 밖의 데이터에서는 권장입니다. 발견 계층은 1단계에서, 이해 계층은 2단계에서 작성합니다.
표준 초안과 어휘표의 관계
표준 초안과 어휘표는 일치합니다. 표준 초안은 필수 요소 중심이고, 어휘표는 외부 어휘까지 포함한 전체 목록입니다.
발견 계층 · 데이터셋 필수 19개
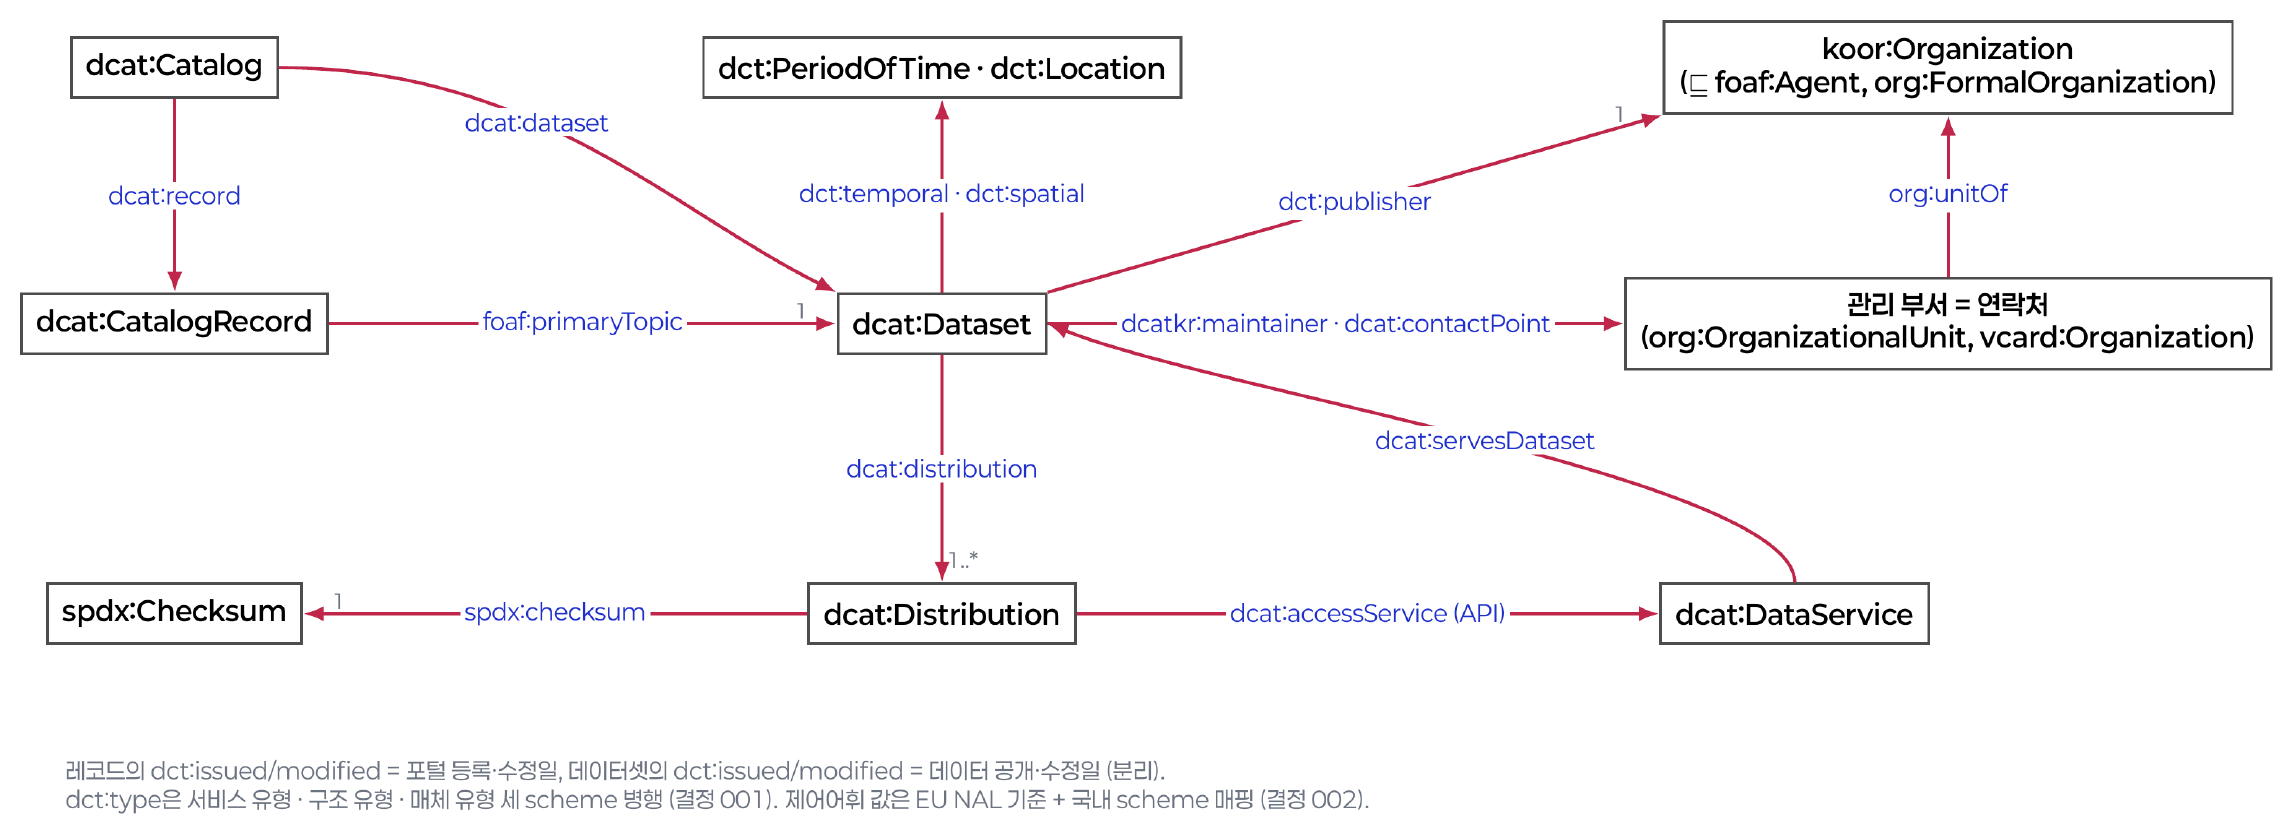
| # | 항목 | 속성 | 개수 | 값 범위 · 판단 기준 | 기재 주체 |
|---|---|---|---|---|---|
| 1 | 데이터셋 식별자 | dct:identifier | 1 | 고유 식별자 URI · 변경 불가 | 조직 정책 |
| 2 | 제목 | dct:title | 1 | 문자열 (@ko) | 담당자 |
| 3 | 설명 | dct:description | 1 | 문자열 | 담당자 |
| 4 | 키워드 | dcat:keyword | 3..* | 3개 이상 | 담당자 |
| 5 | 데이터 서비스 유형 | dct:type | 1 | 통제 어휘 http://vocab.datahub.kr/def/dcat-ap-kr/service-type/ | 담당자 |
| 6 | 데이터셋 구조 유형 | dct:type | 1 이상 | 통제 어휘 http://vocab.datahub.kr/def/aird/dataset-type/ | 담당자 |
| 7 | 언어 | dct:language | 1 이상 | 통제 어휘 http://publications.europa.eu/resource/authority/language/ | 담당자 |
| 8 | 라이프사이클 상태 | aird:lifecycleStatus | 1 | 통제 어휘 http://vocab.datahub.kr/def/aird/lifecycle-status/ | 담당자 |
| 9 | 주제 분류 필수 · 공공 (그 외 권장) | dcat:theme | 1 | 통제 어휘 http://vocab.datahub.kr/def/dcat-ap-kr/data-theme/ | 담당자 |
| 10 | 랜딩 페이지 필수 · 공공 (그 외 권장) | dcat:landingPage | 1 | 데이터 상세 페이지 URL | 담당자 |
| 11 | 생산 주체 | dct:creator | 1 이상 | URI 또는 조직명 | 담당자 |
| 12 | 제공 주체 | dct:publisher | 1 | URI 또는 조직명 | 담당자 |
| 13 | 관리 부서 | dcatkr:maintainer | 1 이상 | 부서명 | 담당자 |
| 14 | 연락처 | dcat:contactPoint | 1 이상 | 이름과 이메일 | 담당자 |
| 15 | 생성 방법 | aird:creationMethod | 1 | 통제 어휘 http://vocab.datahub.kr/def/aird/creation-method/ | 담당자 |
| 16 | 갱신 주기 | dct:accrualPeriodicity | 1 | 통제 어휘 http://publications.europa.eu/resource/authority/frequency/ | 담당자 |
| 17 | 라이선스 | dct:license | 1 | 통제 어휘 http://vocab.datahub.kr/def/dcat-ap-kr/license/ | 담당자 |
| 18 | 이용 조건 | dct:rights | 1 | 이용 범위 고지문 | 담당자 |
| 19 | 접근 권한 | dct:accessRights | 1 | 통제 어휘 http://publications.europa.eu/resource/authority/access-right/ | 담당자 |
발견 계층 · 배포 자원별 필수 4개
배포 형태가 여러 개이면 배포 자원(dcat:Distribution)을 각각 구성하므로, 발견 계층 기재값의 수는 19 + 4 × (배포 자원 수)입니다.
| 항목 | 속성 | 값 범위 | 기재 주체 |
|---|---|---|---|
| 접근 주소 | dcat:accessURL | URI | 담당자 |
| 미디어 타입 | dcat:mediaType | IANA Media Type | 진단 도구 |
| 파일 형식 | dct:format | EU File Type 코드 (예: CSV) | 담당자 |
| 체크섬 | spdx:checksum | SHA-256 (파일에서 계산) | 진단 도구 |
조건부 필수
| 항목 | 속성 | 적용 조건 |
|---|---|---|
| 컬럼 정의서 | csvw:tableSchema | 정형 데이터 |
| 비식별화 수준 | aird:deidentificationLevel | 개인정보 포함 |
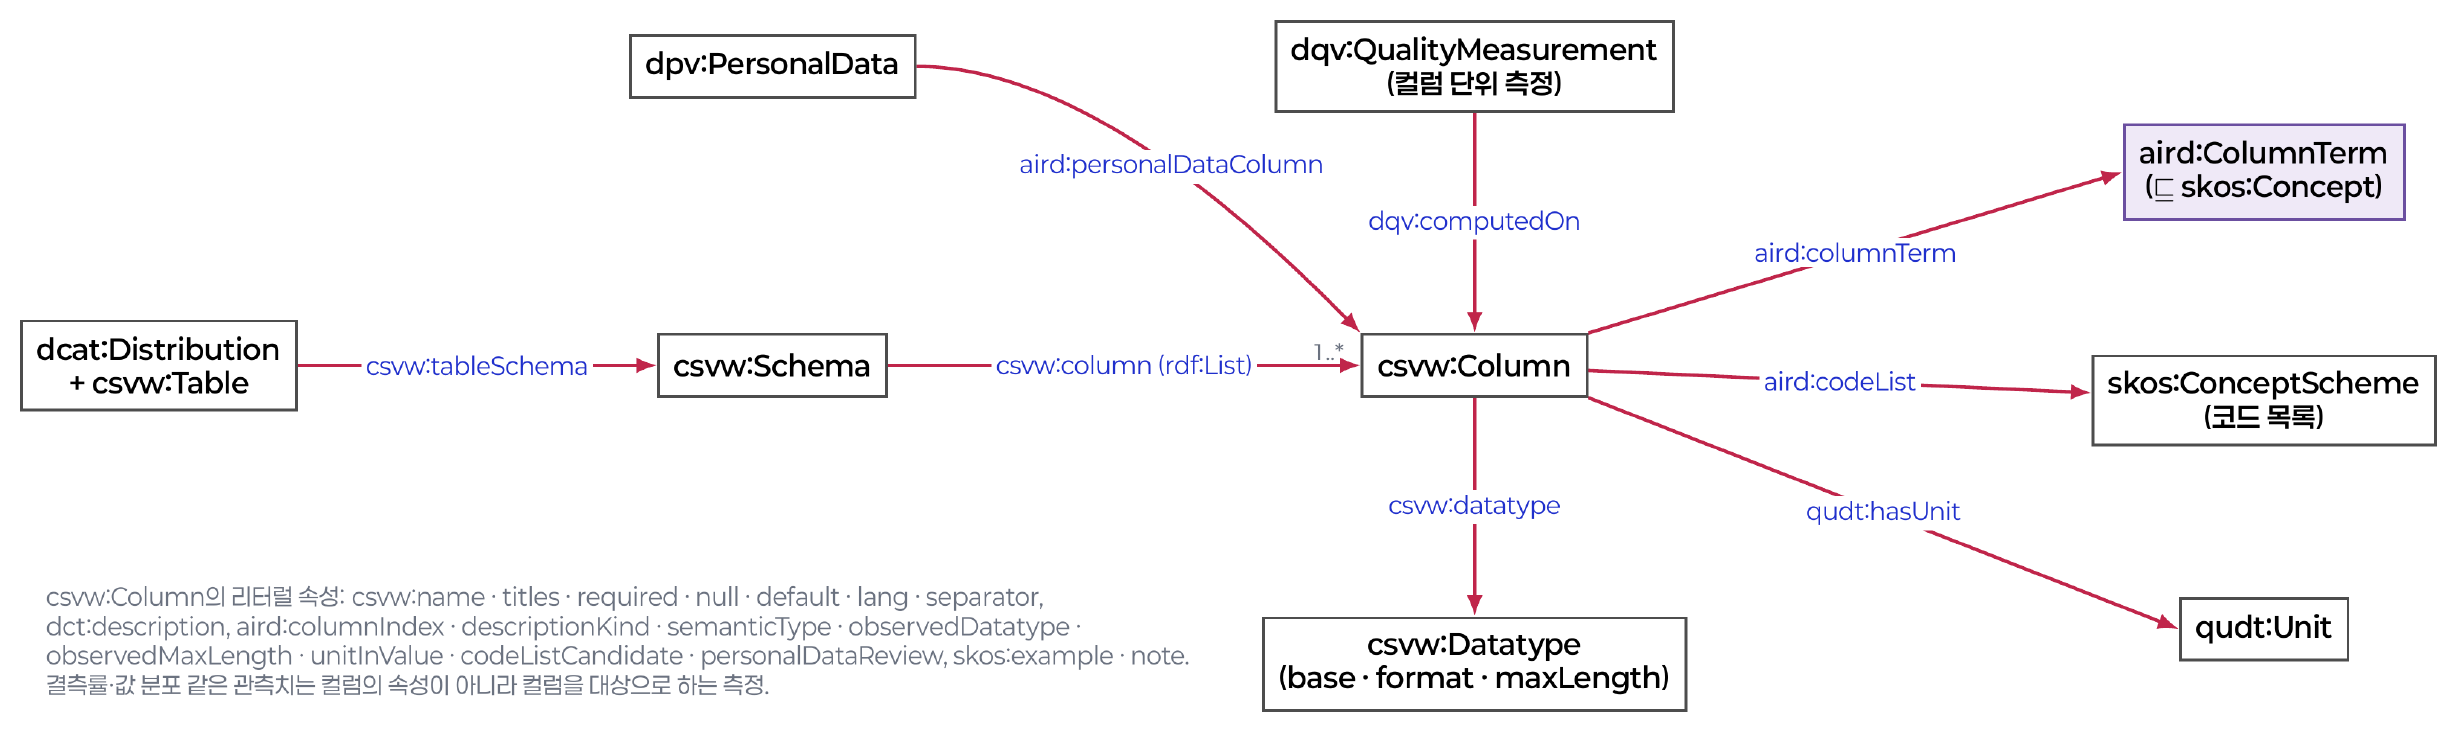
csvw:tableSchema)는 배포(csvw:Table)에 기술합니다. 컬럼마다 이름 · 자료형 · 설명을 두고, AIRD 가 항목을 확장합니다(예: 단위 · 코드 체계).출처: AIRD 정보 모델 v0.10.5 22페이지 · 클릭하면 원본 크기이해 계층 · 주요 항목
구분과 개수는 어휘표 v0.10.5를 따릅니다. 품질 판정(aird:QualityAssessment) · 결정 게이트 기록처럼 묶음에 속한 항목의 「필수」는 그 묶음을 기재할 때 적용합니다. 담당자가 직접 기재하는 항목은 굵게 표시했습니다.
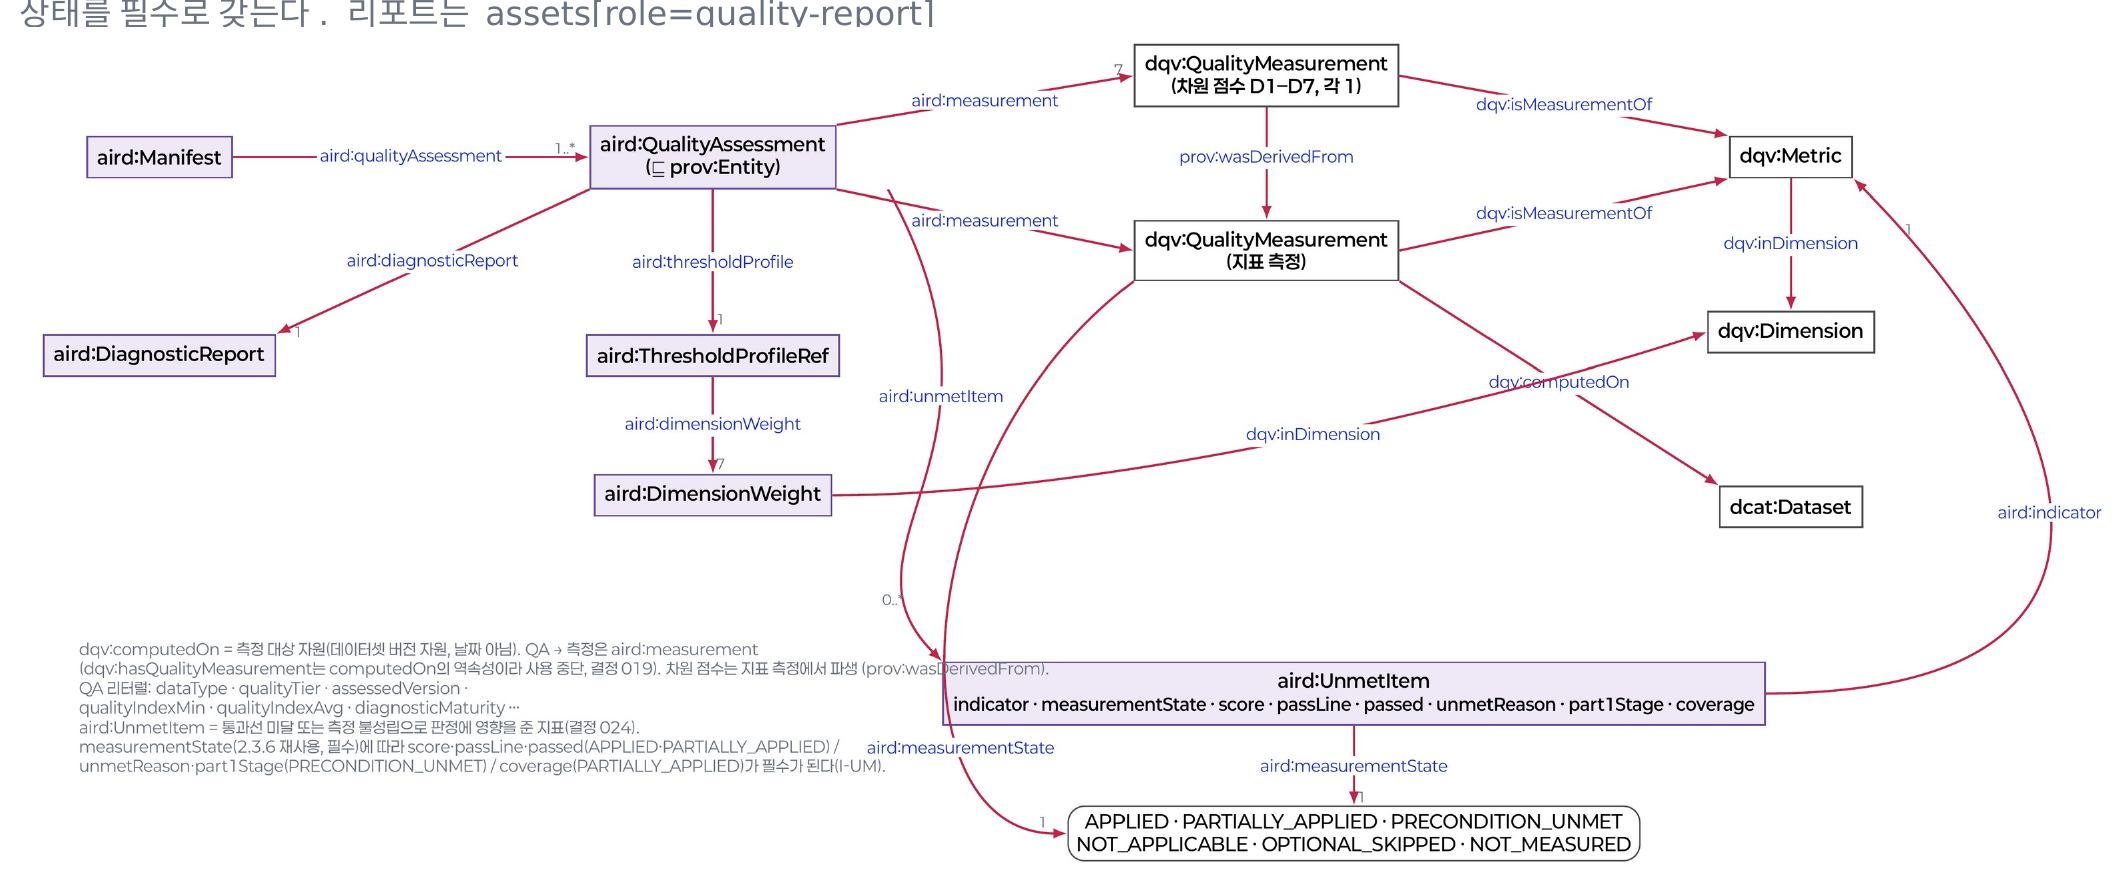
버전 · 이력
| 항목 | 속성 | 어휘표 (번호 · 구분 · 개수) | 기재 주체 |
|---|---|---|---|
| 버전 번호 | dcat:version | 2.1.1 · 필수 · 1..1 | 진단 도구 |
| 최초 등록일 | dct:issued | 1.2.16 · 조건부 필수 · Quality-Ready 이상 · 0..1 | 진단 도구 |
| 최종 수정일 | dct:modified | 1.2.17 · 조건부 필수 · Quality-Ready 이상 · 0..1 | 진단 도구 |
| 버전 노트 | adms:versionNotes | 2.1.2 · 필수 · 1..1 (언어별) | 담당자 |
| 이전 버전 | dcat:previousVersion | 2.1.3 · 조건부 필수 · 규칙 A 새 버전 · 0..1 | 진단 도구 |
품질 판정 — 2.2.1 조건부 필수 · lifecycleStatus = Quality-Ready
| 항목 | 속성 | 어휘표 (번호 · 구분 · 개수) | 기재 주체 |
|---|---|---|---|
| 데이터 유형 | aird:dataType | 2.2.2 · 필수 · 1..1 | 진단 도구 |
| 품질 등급 | aird:qualityTier | 2.2.3 · 필수 · 1..1 | 진단 도구 |
| 최소 차원 점수 | aird:qualityIndexMin | 2.2.9 · 필수 · 1..1 | 진단 도구 |
| 가중 평균 | aird:qualityIndexAvg | 2.2.10 · 필수 · 1..1 | 진단 도구 |
| 최소 측정 지표 점수 | aird:qualityIndexMMI | 2.2.11 · 조건부 필수(DM-0일 때) · 0..1 | 진단 도구 |
| 측정 완성도 | aird:diagnosticMaturity | 2.2.12 · 조건부 필수 · 0..1 | 진단 도구 |
| 전이 적격성 | aird:qualityReadyEligible | 2.2.14 · 조건부 필수 · Quality-Ready 판정 시 · 0..1 | 진단 도구 |
| 진단 일시 | prov:generatedAtTime | 2.2.15 · 필수 · 1..1 | 진단 도구 |
| 판정 규칙 버전 | aird:ruleVersion | 2.2.17 · 필수 · 1..1 | 진단 도구 |
| 스키마 버전 | aird:schemaVersion | 2.2.18 · 필수 · 1..1 | 진단 도구 |
| 결과서 | aird:diagnosticReport | 2.2.19 · 필수 · 1..1 | 진단 도구 |
| 임계 프로파일(판정 기준값) | aird:thresholdProfile | 2.2.20 · 필수 · 1..1 | 진단 도구 |
차원 점수 — 2.3.1 품질 측정 · 필수 · D1~D7 각 1
| 항목 | 속성 | 기재 주체 |
|---|---|---|
| 완전성 | dqv:QualityMeasurement · 차원 D1 (완전성) | 진단 도구 |
| 일관성 | dqv:QualityMeasurement · 차원 D2 (일관성) | 진단 도구 |
| 정확성 | dqv:QualityMeasurement · 차원 D3 (정확성) | 진단 도구 |
| 적시성 | dqv:QualityMeasurement · 차원 D4 (적시성) | 진단 도구 |
| 유효성 | dqv:QualityMeasurement · 차원 D5 (유효성) | 진단 도구 |
| 유일성 | dqv:QualityMeasurement · 차원 D6 (유일성) | 진단 도구 |
| 기계 판독성 | dqv:QualityMeasurement · 차원 D7 (기계 판독성) | 진단 도구 |
구조 · 의미 준비도
| 항목 | 속성 | 어휘표 (번호 · 구분 · 개수) | 기재 주체 |
|---|---|---|---|
| 피처 완전성 지수 | aird:featureCompletenessIndex | 2.4.1 · 권장 · 0..1 | 진단 도구 |
| 스키마 적합률 | aird:schemaConformanceRate | 2.4.2 · 권장 · 0..1 | 진단 도구 |
| 라벨 적합률 | aird:labelConformanceRate | 2.4.3 · 조건부 필수 · 지도학습 · 0..1 | 진단 도구 |
신뢰 · 윤리
| 항목 | 속성 | 어휘표 (번호 · 구분 · 개수) | 기재 주체 |
|---|---|---|---|
| 알려진 편향 | rai:dataBiases | 2.5.1 · 필수 · 1..* | 담당자 |
| 알려진 한계 | rai:dataLimitations | 2.5.2 · 필수 · 1..* | 담당자 |
| 결측 정보 | rai:dataCollectionMissingData | 2.5.3 · 필수 · 1..1 | 담당자 |
| 합성 데이터 여부 | aird:isSynthetic | 2.5.9 · 필수 · 1..1 | 담당자 |
출처 이력
| 항목 | 속성 | 어휘표 (번호 · 구분 · 개수) | 기재 주체 |
|---|---|---|---|
| 원천 데이터 | prov:wasDerivedFrom | 2.6.1 · 조건부 필수 · 규칙 B 파생 데이터셋 · 0..* | 담당자 |
| 수집 방법 | aird:collectionMethod | 1.2.12 · 조건부 필수 · Quality-Ready 이상 · 0..1 | 담당자 |
| 전처리 활동 | prov:wasGeneratedBy | 2.6.2 · 조건부 필수 · preprocessingLevel ≠ NONE 또는 파생 데이터셋: 1..*; 그 외 0..* · 0..* | 진단 도구 |
| 변환 이력 | prov:wasGeneratedBy | 2.6.3 · 조건부 필수 · purposeState = ready · 0..* | 진단 도구 |
결정 게이트 판정 기록
| 항목 | 속성 | 어휘표 (번호 · 구분 · 개수) | 기재 주체 |
|---|---|---|---|
| 게이트 종류 | aird:gateType | 2.7.2 · 필수 · GD · 1..1 | 진단 도구 |
| 게이트 결과 | aird:gateResult | 2.7.3 · 필수 · GD · 1..1 | 진단 도구 |
| 판정 일시 | prov:endedAtTime | 2.7.4 · 필수 · GD · 1..1 | 진단 도구 |
| 도달 상태 | aird:resultingStatus | 2.7.5 · 조건부 필수 · G1·G2 PASS · 0..1 | 진단 도구 |
목적 준비도
| 항목 | 속성 | 어휘표 (번호 · 구분 · 개수) | 기재 주체 |
|---|---|---|---|
| 목적 준비도 | aird:purposeReadiness | 2.8.1 · 조건부 필수 · purposeState = ready인 목적 존재 · 0..* | 진단 도구 |
| 목적 판정 상태 | aird:purposeAssessmentStatus | 2.8.8 · 조건부 필수 · 미판정 유형 존재 · 0..* | 진단 도구 |
보안 · 프라이버시
| 항목 | 속성 | 어휘표 (번호 · 구분 · 개수) | 기재 주체 |
|---|---|---|---|
| 개인정보 포함 | aird:containsPersonalData | 2.9.1 · 필수 · 1..1 | 담당자 |
| 민감정보 포함 | aird:containsSensitiveData | 2.9.3 · 조건부 필수 · 개인정보 포함 시 · 0..1 | 담당자 |
| 비식별화 수준 | aird:deidentificationLevel | 1.4.8 · 조건부 필수 · 개인정보 포함 · 0..1 | 담당자 |
값 목록
다음 항목의 값은 자유 문자열이 아니라 정해진 목록에서 선택하여 기재합니다.
| 항목 | 값 | 출처 |
|---|---|---|
data_type | STRUCT · TEXT · IMAGE · TSERIES · PT | [제1부 5.6 표 5-5] |
lifecycle_status | Discoverable · Quality-Ready · Purpose-Ready · Stale | |
creation_method | collected 수집 · processed 가공 · synthetic 합성 · augmented 증강 | |
access_rights | PUBLIC 공개 · RESTRICTED 제한 · NON_PUBLIC 비공개 | EU Publications Office · Access right authority table |
language | 예: KOR 한국어 · ENG 영어 | EU Publications Office · Language authority table |
media_type | 예: text/csv · application/json · image/jpeg | IANA Media Types |
license | KOGL-0 · KOGL-1 · KOGL-2 · KOGL-3 · KOGL-4 · KOGL-AI · NO-RESTRICTION · CC-BY-4.0 · CC-BY-SA-4.0 · CC-BY-ND-4.0 · CC-BY-NC-4.0 · CC-BY-NC-SA-4.0 · CC-BY-NC-ND-4.0 · CC0-1.0 | 어휘표 v0.10.5 1.4.1 · kr-license (DCAT-AP-KR 통합 어휘 · 제안) — 기준 어휘 KOGL-THIRD-PARTY(제3자 권리 포함)는 라이선스가 아닌 권리 상태라 어휘표가 dct:license 값에서 제외했습니다(deprecated) — dct:rights 고지문에 적습니다. 표준 초안과 어휘표는 일치합니다. 표준 초안은 필수 요소 중심이고, 어휘표는 외부 어휘까지 포함한 전체 목록입니다. 기업의 자체 이용약관 · MIT · Apache 등은 이 목록에 값이 없습니다 — 값 공간 확장은 어휘표 개정 제안입니다 |
frequency | 예: ANNUAL · QUARTERLY · MONTHLY · DAILY · IRREG | EU Publications Office · Frequency authority table |
갱신 주기 — 담당자 입력값과 마니페스트 기재값
| 담당자 입력값 | 마니페스트 기재값 |
|---|---|
| 연 1회 갱신 | http://publications.europa.eu/resource/authority/frequency/ANNUAL |
| 분기 갱신 | http://publications.europa.eu/resource/authority/frequency/QUARTERLY |
| 월 1회 갱신 | http://publications.europa.eu/resource/authority/frequency/MONTHLY |
| 매일 갱신 | http://publications.europa.eu/resource/authority/frequency/DAILY |
| 수시·비정기 | http://publications.europa.eu/resource/authority/frequency/IRREG |
기타 값
| 담당자 입력값 | 마니페스트 기재값 |
|---|---|
| 공공누리 제1유형 | KOGL-1 |
| CC BY 4.0 | CC-BY-4.0 |
| 기업의 자체 이용약관 (재배포 · 자동 수집 제한) | 목록에 값 없음 — 이용 조건(dct:rights)에 약관 이름과 시행일을 적습니다 |
| CSV 파일 | text/csv |
| JSON 파일 | application/json |
| 누구나 볼 수 있음 | http://publications.europa.eu/resource/authority/access-right/PUBLIC |
| 승인받은 조직 · 계약 고객만 | http://publications.europa.eu/resource/authority/access-right/RESTRICTED |
| 조사·측정해서 만든 데이터 | collected |
| 기존 데이터를 가공한 것 | processed |
| 한국어 | http://publications.europa.eu/resource/authority/language/KOR |
근거: 제3부 부속서 A.1, A.2, 부속서 C
품질 지표
16개 정식 품질 지표의 유형별 적용, 전제 조건, 측정식을 정리한 조회표입니다. 모든 점수는 0 이상 1 이하이고, 가중치와 등급 구간은 운영 지침의 임계 프로파일(판정 기준값)을 따릅니다.
유형별 적용
● 정식 필수 · ○ 선택 · — 적용하지 않음을 뜻합니다. MMI는 진단의 진입 요건이 되는 최소 측정 지표입니다.
| ID | 지표 | 차원 | STRUCT | TEXT | IMAGE | TSERIES | PT | |
|---|---|---|---|---|---|---|---|---|
D1-01 | 필수 필드 충족도 | D1 완전성 | ● | ○ | ○ | ● | ● | |
D1-02 | 필수 메타데이터 항목 충실도 | D1 완전성 | ● | ● | ● | ● | ● | |
D2-01 | 필드 간 관계 일관성 | D2 일관성 | ● | — | — | ● | — | |
D2-02 | 참조 무결성 | D2 일관성 | ● | — | — | ● | — | |
D2-03 | 파생값 정확성 | D2 일관성 | ● | — | — | ● | — | |
D3-01 | 표준 명칭 정합성 | D3 정확성 | ● | ○ | — | ○ | — | |
D3-02 | 라벨 정확성 | D3 정확성 | — | ○ | ● | — | ● | |
D4-01 | 최신성 | D4 적시성 | ● | ● | ○ | ● | ● | |
D4-02 | 갱신 충실도 | D4 적시성 | ○ | ○ | — | — | ○ | |
D4-03 | 시계열 완비도 | D4 적시성 | — | — | — | ● | — | |
D5-01 | 형식 유효성 | D5 유효성 | ● | ● | — | ● | ● | |
D5-02 | 수치 범위 유효성 | D5 유효성 | ● | — | — | ● | — | |
D5-03 | 통계적 타당성 | D5 유효성 | MMI | ● | — | — | ● | — |
D6-01 | 유일성 | D6 유일성 | MMI | ● | ○ | — | ● | ● |
D7-01 | 인코딩 일관성 | D7 기계 판독성 | MMI | ● | ● | ○ | ● | ● |
D7-02 | 기술적 유효성 | D7 기계 판독성 | MMI | ● | ● | ● | ● | ● |
| 정식 필수 지표 수 | 13 | 5 | 3 | 13 | 8 |
지표별 전제 조건과 측정식
D1-01 필수 필드 충족도 — 필수 컬럼의 비결측 비율
전제 조건 필수 필드 목록이 컬럼 정의서(csvw:tableSchema), 데이터셋에 적용한 메타데이터 규격, 또는 기관이 승인한 동등 문서에 정의되어 있을 것
측정식
(1 / |Freq|) × Σ_{f∈Freq} [ n(f ≠ NULL ∧ f ≠ '') / N ]기호 Freq 필수 필드 집합 · |Freq| 필수 필드 수 · N 전체 레코드 수
D1-02 필수 메타데이터 항목 충실도 — 필수 기재 항목의 기재 비율
전제 조건 데이터셋에 적용한 메타데이터 규격이 이 지표의 분모로 삼을 항목 목록을 지정하고 있을 것. 목록을 지정하지 않은 규격은 그 규격의 필수 항목 전체를 분모로 삼습니다
측정식
n(기재된 필수 메타데이터 항목) / n(전체 필수 메타데이터 항목)D2-01 필드 간 관계 일관성 — 두 컬럼 간 관계 규칙 준수 여부
전제 조건 관계 규칙이 컬럼 정의서(csvw:tableSchema), 데이터셋에 적용한 메타데이터 규격, 기관이 승인한 동등 문서 가운데 하나에 정의되어 있을 것
측정식
1 − ( n(규칙 위배 레코드) / N )D2-02 참조 무결성 — 코드값의 코드표 등재 여부
전제 조건 마스터 코드 테이블의 실제 값을 대조할 것. 주소나 참조만 있고 값을 취득하지 못하면 전제 조건 미충족(PRECONDITION_UNMET)으로 판정합니다
측정식
1 − ( n(미매핑 코드 셀) / n(유효 코드 셀) )선행 지표 D5-01
D2-03 파생값 정확성 — 저장된 파생값의 계산 규칙 일치 여부
전제 조건 파생값 계산 규칙이 스키마, 컬럼 정의서(csvw:tableSchema), 또는 데이터셋에 적용한 메타데이터 규격에 정의되어 있을 것. 저장된 파생값이 없으면 해당 없음(NOT_APPLICABLE)으로 판정합니다
측정식
1 − ( n(산출값 ≠ 저장값) / n(검증 대상) )D3-01 표준 명칭 정합성 — 코드와 명칭의 공인 기준 일치 여부
전제 조건 공인 참조 기준이 코드와 명칭의 대응 형태로 활용 가능하고, 데이터에 코드와 명칭이 함께 존재할 것
측정식
1 − ( n(기준 불일치 코드 셀) / n(매칭된 코드 셀) )선행 지표 D2-02
D3-02 라벨 정확성 — 라벨의 정답 라벨 일치 비율
전제 조건 전문가 검수를 완료한 정답 라벨 집합이 존재할 것. 자동 측정이 성립하지 않으며 검수 결과를 입력으로 사용합니다
측정식
n(일치) / n(검수 대상). 텍스트와 페어형 텍스트는 완전 일치를 일치로 판정한다D4-01 최신성 — 기재한 갱신 주기 내 갱신 여부
전제 조건 메타데이터에 갱신일과 갱신 주기가 기록되어 있을 것
측정식
경과일수 ≤ 갱신주기이면 1.0. 그 밖의 경우 max(0, 1 − (경과일수 − 갱신주기) / 유예기간). 유예기간은 갱신 주기와 같은 일수이다D4-02 갱신 충실도 — 예정 갱신의 이행 비율
전제 조건 메타데이터에 갱신 주기와 갱신 이력이 명시되어 있을 것
측정식
n(이행된 갱신) / n(예정된 갱신)D4-03 시계열 완비도 — 시계열 측정 시점의 누락 여부
전제 조건 메타데이터에 기대 측정 시점이 명시되어 있을 것
측정식
n(실제 측정 시점) / n(기대 측정 시점)D5-01 형식 유효성 — 값의 정의 형식 준수 여부
전제 조건 없음. 형식이 정의되지 않은 컬럼은 측정 대상에서 제외합니다
측정식
1 − ( n(형식 불일치 셀) / n(형식 검증 대상 셀) )D5-02 수치 범위 유효성 — 수치의 허용 범위 준수 여부
전제 조건 컬럼별 허용 범위가 정의되어 있을 것. 정의된 컬럼이 하나도 없으면 전제 조건 미충족(PRECONDITION_UNMET)으로 판정합니다
측정식
1 − ( n(범위 초과 셀) / n(범위가 정의된 셀) )D5-03 통계적 타당성 — 더미값 · 명백한 오류값 포함 여부
전제 조건 더미값 패턴(임계 프로파일의 지표 파라미터). 운영 지침이 없으면 제2부 부록 Ⅰ 예시 패턴으로 잠정 측정합니다(판정 절차).
측정식
1 − ( n(명백한 오류값 셀) / n(평가 대상 수치 셀) )D6-01 유일성 — 레코드 중복 여부
전제 조건 없음
측정식
n(유니크 키) / N. 식별 컬럼이 정의된 경우 동일 개체의 중복을 측정하고, 식별 컬럼이 없는 경우 전체 컬럼의 조합을 키로 사용하여 완전 동일 레코드의 중복을 측정한다D7-01 인코딩 일관성 — 파일 인코딩의 기준 인코딩 일치 여부
전제 조건 없음
측정식
n(기준 인코딩 준수 파일) / n(전체 파일)D7-02 기술적 유효성 — 파일 정상 개방 · 구조 유효 여부
전제 조건 없음
측정식
n(정상 개방 ∧ 사양 충족 파일) / n(전체 파일). 사양 충족은 파일 형식의 공식 사양에 따라 파싱이 완료되고 필수 구조가 유효한 경우로 판정한다산정
| 값 | 식 |
|---|---|
| 차원 점수 | Di = Σk (wk × Sk) / Σk wk |
| 최소 차원 점수 | min(Di) |
| 가중 평균 | Σi (Wi × Di) |
| 최소 측정 지표 점수 | Σ score(MMI) / n(MMI) |
| 가중치 재배분 | Wi′ = Wi / (1 − Wj) # Wj 는 측정하지 못한 차원들의 가중치 합 |
| 측정 충족률 (평가 범위) | Σ statusFactor(적용 대상 정식 필수 지표) / n(NOT_APPLICABLE 을 제외한 정식 필수 지표) |
Sk는 그 데이터 유형의 정식 필수 지표 가운데 측정을 완료한 지표의 점수입니다. 선택 지표와 미완료 지표는 분자와 분모 모두에서 제외하고, 차원 안에 완료된 정식 지표가 하나도 없으면 Di를 null로 기록합니다.
등급 판정은 가중 평균이 아니라 최소 차원 점수에서 출발합니다(판정 절차). 측정 충족률(평가 범위)은 측정 완성도 DM-1 판정에서 운영 지침의 하한과 비교합니다.
부분 측정
부분 측정(PARTIALLY_APPLIED)은 D2-02 · D3-01 · D5-02에 적용하며, coverage는 n(측정 가능 대상) / n(식별된 측정 대상)입니다. 전제를 충족한 대상만 모집단으로 삼고, 측정하지 못한 대상은 분자와 분모 모두에서 제외합니다. coverage는 점수에 다시 곱하지 않습니다.
부분 측정이 있으면 DM-2가 성립하지 않으며, 측정 완성도(표준 용어: 진단 성숙도, DM)의 상한은 DM-1입니다.
배타성 — 동일 결함의 지표 간 중복 집계 금지
하나의 결함은 다음 표의 담당 지표에서만 집계합니다.
| 결함 유형 | 담당 지표 |
|---|---|
| 단일 필드의 형식 위배 | D5-01 |
| 단일 필드의 범위 초과 | D5-02 |
| 두 필드 사이의 관계 위배 | D2-01 |
| 다중 필드의 계산 결과 불일치 | D2-03 |
| 비어 있는 셀 | D1-01 |
| 매핑되지 않은 코드 | D2-02 |
기준 인코딩
| 기준 | 미준수 | 측정 대상 아님 |
|---|---|---|
UTF-8 | EUC-KR · CP949 | 바이트 순서 표시의 유무 · 줄바꿈 문자의 차이 |
근거: 제2부 부속서 A.1~A.4, B.1~B.6
상태값과 판정값
결과서(표준 용어: 진단 리포트)와 마니페스트에 기재하는 판정값의 목록입니다. 판정할 수 없는 결과는 0점이나 최저 등급이 아니라 「판정하지 않음」과 사유로 기재합니다.
층
표준이 규정한 진단 상태 · 지표 적용성 · 측정 완성도(표준 용어: 진단 성숙도, DM)가 기준 층이며, 표시층은 이를 사람이 읽는 말로 옮길 뿐 새로운 판정을 생성하지 않습니다.
| 층 | 답하는 질문 | 규범 | 근거 |
|---|---|---|---|
| 진단 상태 | 진단 진입 가능 여부 | 규범 | [제2부 부속서 B.1 표 B.1] |
| 지표 적용성 | 지표 측정 여부와 미측정 사유 | 규범 | [제2부 부속서 B.2 표 B.2] |
| 확인 결과 표시 | 항목(지표 · 기재 항목 · 요건)별 확인 결과를 나타내는 단일 표시값 | 표시층 | — |
| 판정하지 않음 사유 | 판정하지 않은 사유 | 표시층 (목적 등급 사유는 표준 코드) | [제3부 부속서 C.22] |
| 측정 완성도 판정 | 요구된 지표의 측정 완료 정도 | 규범 | [제2부 부속서 B.5 표 B.4] |
| 평가 상태 | 평가가 확정인지 잠정인지 | 규범 | [제3부 부속서 C.20] |
| 결정 게이트 판정 | 확인 지점의 통과 여부 | 규범 | [제3부 부속서 C.21] |
진단 상태
| 값 | 뜻 |
|---|---|
DIAGNOSED | 진단 절차를 수행한 상태 |
SCHEMA_ONLY | 레코드가 1건도 없어 스키마만 존재하는 상태 |
FILE_BROKEN | 파일 개방이나 구조 파싱이 성립하지 않는 상태 |
SCHEMA_ONLY와 FILE_BROKEN에서는 측정 완성도와 등급을 null로 기록합니다. SCHEMA_ONLY는 첫 인스턴스를 적재하는 시점에 해소됩니다.
지표 적용성 · 규범적 계약
| 적용성 | 뜻 | 지표 점수 | statusFactor | 담당자 조치 |
|---|---|---|---|---|
APPLIED | 측정함 | 점수 | 1 | 없음 |
PARTIALLY_APPLIED | 일부 대상만 측정 | null | coverage | 나머지 대상의 기준 자료 확보 |
PRECONDITION_UNMET | 선행 조건(기준 자료 등)이 없어 측정하지 못함 | null | 0 | 기준 자료 확보 후 측정 |
NOT_APPLICABLE | 이 유형 · 조건에 적용되지 않음 | null | 산정에서 제외 | 없음 |
OPTIONAL_SKIPPED | 선택 지표를 생략함 | null | 산정에서 제외 | 없음 |
품질 지수와 운영 지침 기준 등급은 적용 대상 정식 필수 지표의 APPLIED 결과만 사용하므로, 선택 지표는 APPLIED가 되어도 산정에 포함하지 않습니다. 등급을 판정하려면 적용 대상 정식 필수 지표가 모두 APPLIED(측정 완성도 DM-2)여야 합니다.
확인 결과 표시
| 표시 | 뜻 | 기준 층 대응 |
|---|---|---|
| 충족 | 측정·확인했고 기준을 충족 | APPLIED + 기준 충족 |
| 미충족 | 측정·확인했으나 기준 미달 | APPLIED + 기준 미달 |
| 미측정 | 적용 대상이지만 아직 측정하지 않음 | PRECONDITION_UNMET · PARTIALLY_APPLIED |
| 해당 없음 | 그 데이터 유형이나 목적에 적용되지 않음, 또는 선택 지표를 생략함 | NOT_APPLICABLE · OPTIONAL_SKIPPED |
| 판정하지 않음 | 판정에 필요한 조건이 성립하지 않음 | 판정하지 않음 사유와 함께 기재합니다 |
0점은 「측정했고 낮음」이므로 미측정·해당 없음·판정하지 않음과 구분합니다. 「판정하지 않음」도 판정 결과 미달과 다르므로 최하 등급이나 해당 없음과 구분하여 기재합니다. OPTIONAL_SKIPPED는 「해당 없음」으로 표시하고, 선택 지표를 생략했음을 사유로 기재합니다.
판정하지 않음 사유
표시 형식: 판정하지 않음: <사유>
| 대상 | 사유 | 뜻 | 근거 |
|---|---|---|---|
| 품질 등급 | 운영 지침 미적용 | 점수는 있으나 등급으로 옮길 운영 지침을 적용하지 않았습니다 | — |
| 품질 등급 | DM-2 미달 | 측정 완성도가 DM-2가 아닙니다 | — |
| 목적 등급 | PROFILE_NOT_REGISTERED 목적 프로파일 미등록 | 그 활용 목적의 프로파일이 등록되지 않았습니다 | [제3부 부속서 C.22] |
| 목적 등급 | THRESHOLD_NOT_PUBLISHED 임계값 미공개 | 목적 프로파일은 있으나 임계값이 공개되지 않았습니다 | [제3부 부속서 C.22] |
| 목적 등급 | PRECONDITION_UNMET 선행 조건 미충족 | 앞 단계의 조건을 충족하지 못했습니다 | [제3부 부속서 C.22] |
목적 등급의 PRECONDITION_UNMET은 지표 적용성의 PRECONDITION_UNMET과 코드가 같지만 대상이 다릅니다.
측정 완성도 판정 표시
| 결정표 결과 | 표시 |
|---|---|
DM-2 | DM-2 |
DM-1 | DM-1 |
DM-0 | DM-0 |
null(5행) | DM-0 미성립 |
null(1행) | 판정하지 않음 (진단 상태 예외) |
결정표의 각 행은 판정 절차에 있습니다.
평가 상태와 결정 게이트 판정
| 구분 | 값 | 뜻 | 근거 |
|---|---|---|---|
| 평가 상태 | OFFICIAL | 운영 지침의 OFFICIAL 임계 프로파일을 적용한 평가 | [제3부 부속서 C.20] |
| 평가 상태 | PROVISIONAL | 잠정 평가 (예: 운영 지침 없이 D5-03(통계적 타당성)을 제2부 부록 Ⅰ 예시 패턴으로 측정) | [제3부 부속서 C.20] |
| 결정 게이트 판정 | PASS | 확인 지점(G1 · G2 · G3)의 전이 조건을 충족함 | [제3부 부속서 C.21] |
| 결정 게이트 판정 | FAIL | 확인 지점의 전이 조건을 충족하지 못함 | [제3부 부속서 C.21] |
확인 지점의 정의는 제1부 5.2에 있고, 판정은 제2부가 다룹니다.
근거: 제1부 5.2 · 제2부 부속서 B.1 표 B.1, B.2 표 B.2, B.5 표 B.4 · 제3부 부속서 C.20, C.21, C.22
마니페스트 예시
예시 데이터(사업장 등록 정보 20건)의 데이터 설명서(마니페스트) 전체입니다. 발견 계층과 이해 계층의 속성을 JSON-LD 문서 하나에 기재하는 방식을 보여 줍니다.
판단별 판독 속성
에이전트는 마니페스트 하나로 4가지 판단을 시작합니다.
| 판단 | 이 마니페스트의 판독 속성 |
|---|---|
| 적합성 | dct:description · csvw:tableSchema · dct:type |
| 신뢰성 | aird:lifecycleStatus · dct:accrualPeriodicity · spdx:checksum |
| 결합성 | dct:identifier · csvw:tableSchema |
| 사용 가능성 | dct:license · dct:rights · dct:accessRights |
발견 계층 — 1단계를 완료한 마니페스트
예시 파일의 기재 예(meta.json)를 식별자만 이 사이트의 예시 식별자로 바꾸어 수록했습니다. 발견 계층 필수 기재 항목 23개와 컬럼 정의서(csvw:tableSchema)를 모두 채웠고, 체크섬은 example.csv의 실제 SHA-256입니다.
간이 표기와 접두어 선언
이 예시는 마니페스트와 데이터셋을 한 노드로 합친 간이 표기입니다. 표준은 데이터셋(실체)과 마니페스트(기술 문서)의 식별자를 나누며, 나눈 구조는 팩 구성과 배포 — 준비 상태별 필요한 파일의 마니페스트 발췌에 있습니다.
컬럼 설명의 dc:description은 외부 컨텍스트에서 dc 접두어를 선언한다는 전제에 따르며, 이 문서의 로컬 컨텍스트에는 해당 선언이 없습니다.
{
  "@context": [
    "https://datahub.kr/ns/aird-context-3.0.jsonld",
    {
      "dct": "http://purl.org/dc/terms/",
      "dcat": "http://www.w3.org/ns/dcat#",
      "aird": "http://vocab.datahub.kr/def/aird/",
      "aird-ml": "http://vocab.datahub.kr/def/aird-ml/",
      "aird-kg": "http://vocab.datahub.kr/def/aird-kg/",
      "csvw": "http://www.w3.org/ns/csvw#",
      "dqv": "http://www.w3.org/ns/dqv#",
      "prov": "http://www.w3.org/ns/prov#",
      "spdx": "http://spdx.org/rdf/terms#",
      "adms": "http://www.w3.org/ns/adms#",
      "vcard": "http://www.w3.org/2006/vcard/ns#",
      "rai": "http://mlcommons.org/croissant/RAI/",
      "dpv": "https://w3id.org/dpv#",
      "cr": "http://mlcommons.org/croissant/",
      "sc": "https://schema.org/",
      "void": "http://rdfs.org/ns/void#",
      "dcatkr": "http://vocab.datahub.kr/def/dcat-ap-kr/",
      "foaf": "http://xmlns.com/foaf/0.1/"
    }
  ],
  "@id": "https://data.example.go.kr/id/dataset/biz-registry/manifest/1.0.0",
  "@type": "dcat:Dataset",
  "aird:lifecycleStatus": "http://vocab.datahub.kr/def/aird/lifecycle-status/Discoverable",
  "dct:identifier": "https://data.example.go.kr/id/dataset/biz-registry",
  "dct:title": "예시 사업장 등록 정보",
  "dct:description": "지역별 사업장의 등록 정보와 영업 상태를 수록한 예시 데이터셋이다. 이 표준의 적용 절차를 보이기 위하여 작성하였다.",
  "dcat:keyword": [
    "사업장",
    "산업분류",
    "지역",
    "영업상태"
  ],
  "dct:type": [
    "http://vocab.datahub.kr/def/dcat-ap-kr/service-type/FILE",
    "http://vocab.datahub.kr/def/aird/dataset-type/Structured"
  ],
  "dct:language": [
    "http://publications.europa.eu/resource/authority/language/KOR"
  ],
  "csvw:tableSchema": {
    "columns": [
      {
        "name": "bizId",
        "datatype": "string",
        "dc:description": "사업장 고유 등록번호. B-YYYY-NNNN 형식",
        "required": true
      },
      {
        "name": "bizName",
        "datatype": "string",
        "dc:description": "사업장 명칭"
      },
      {
        "name": "industryCode",
        "datatype": "string",
        "dc:description": "한국표준산업분류 세세분류 코드"
      },
      {
        "name": "regionCode",
        "datatype": "string",
        "dc:description": "행정표준코드 법정동 시군구 코드"
      },
      {
        "name": "employeeCount",
        "datatype": "integer",
        "dc:description": "상시 종업원 수. 0 이상 100000 이하"
      },
      {
        "name": "revenueBand",
        "datatype": "string",
        "dc:description": "매출 구간 코드. B1부터 B4까지"
      },
      {
        "name": "registeredOn",
        "datatype": "date",
        "dc:description": "최초 등록일. ISO 8601-1 날짜"
      },
      {
        "name": "closedFlag",
        "datatype": "integer",
        "dc:description": "폐업 여부. 0은 영업, 1은 폐업"
      }
    ],
    "primaryKey": "bizId"
  },
  "dct:creator": [
    "https://data.example.go.kr/org/example-agency"
  ],
  "dct:publisher": "https://data.example.go.kr/org/example-agency",
  "dcat:contactPoint": {
    "@type": "vcard:Contact",
    "vcard:fn": "예시기관 데이터관리팀",
    "vcard:hasEmail": "mailto:data@example.go.kr"
  },
  "aird:creationMethod": "http://vocab.datahub.kr/def/aird/creation-method/collected",
  "dct:accrualPeriodicity": "http://publications.europa.eu/resource/authority/frequency/ANNUAL",
  "dct:license": "http://vocab.datahub.kr/def/dcat-ap-kr/license/KOGL-1",
  "dct:rights": "공공누리 제1유형. 출처를 표시하면 상업적 이용과 변형을 허용한다.",
  "dct:accessRights": "http://publications.europa.eu/resource/authority/access-right/PUBLIC",
  "dcat:distribution": [
    {
      "@type": "dcat:Distribution",
      "dcat:accessURL": "https://data.example.go.kr/aird/example-registry/data/example.csv",
      "dcat:mediaType": "text/csv",
      "dct:format": "http://publications.europa.eu/resource/authority/file-type/CSV",
      "spdx:checksum": {
        "spdx:algorithm": "SHA-256",
        "spdx:checksumValue": "7ad8add25d7a638322dd869f08b2fc7d64a4b12a3755c58ca9a10ee8646d78ea"
      }
    }
  ],
  "dcat:theme": [
    "http://vocab.datahub.kr/def/dcat-ap-kr/data-theme/INDUSTRY_EMPLOYMENT"
  ],
  "dcat:landingPage": "https://data.example.go.kr/dataset/biz-registry",
  "dcatkr:maintainer": {
    "@type": "foaf:Agent",
    "foaf:name": "예시기관 데이터관리팀"
  }
}
이해 계층 — 2단계에서 더해지는 것 예시
같은 데이터의 측정 결과를 기록한 예시입니다. 운영 지침을 적용하지 않았으므로 품질 등급(aird:qualityTier)과 임계 프로파일(판정 기준값, aird:thresholdProfile)이 비어 있으며, 이는 정상 결과입니다. 에이전트는 빈 값을 0점이 아니라 「판정하지 않음: 운영 지침 미적용」으로 해석합니다.
D5-03(통계적 타당성)은 제2부 부록 Ⅰ의 예시 패턴으로 잠정 측정했습니다. 정식 필수 지표 13개 중 7개만 측정했으므로 측정 완성도(표준 용어: 진단 성숙도, DM)는 DM-0(잠정)입니다.
속성 표기와 차원 점수
측정 완성도를 결정하는 절차는 판정 절차에 있습니다. 속성 표기는 표준 스키마가 발행되면 이에 맞춥니다.
차원 점수(aird:completenessScore 등)는 읽기 쉽게 줄여 쓴 표기입니다. 어휘표 v0.10.5는 차원 점수를 품질 측정(dqv:QualityMeasurement, 2.3.1 — D1~D7 각 1건)으로 기록합니다.
{
  "@id": "https://data.example.go.kr/id/dataset/biz-registry/manifest/1.1.0",
  "dcat:previousVersion": "https://data.example.go.kr/id/dataset/biz-registry/manifest/1.0.0",
  "aird:lifecycleStatus": "http://vocab.datahub.kr/def/aird/lifecycle-status/Discoverable",
  "aird:dataType": "STRUCT",
  "dqv:computedOn": "https://data.example.go.kr/id/dataset/biz-registry",
  "prov:generatedAtTime": "2026-10-05",
  "aird:completenessScore": 1.0,
  "aird:validityScore": 1.0,
  "aird:uniquenessScore": 1.0,
  "aird:machineReadabilityScore": 1.0,
  "aird:diagnosticMaturity": "DM-0",
  "aird:qualityTier": null,
  "aird:thresholdProfile": null,
  "aird:diagnosticReport": {
    "@id": "https://data.example.go.kr/id/dataset/biz-registry/report/2026-10-05",
    "spdx:checksum": {
      "spdx:algorithm": "SHA-256",
      "spdx:checksumValue": "(결과서 파일의 SHA-256)"
    }
  },
  "rai:dataLimitations": [
    "폐업 신고 지연으로 closedFlag의 반영 시점이 실제 폐업 시점보다 늦을 수 있다"
  ]
}
검증된 사실 1건 예시 제안
진단으로 확인한 사실 1건을 측정값 1건으로 기재한 예이며, 표준에서 이미 사용하는 DQV 어휘를 따릅니다. aird:targetColumn · aird:referenceStandard · aird:validUntil은 제안된 속성입니다.
{
  "@type": "dqv:QualityMeasurement",
  "dqv:isMeasurementOf": "aird:D2-02",
  "dqv:computedOn": "https://data.example.go.kr/id/dataset/biz-registry",
  "prov:generatedAtTime": "2026-10-05",
  "dqv:value": 0.997,
  "aird:targetColumn": "regionCode",
  "aird:referenceStandard": "행정표준코드 법정동 (버전 명시)",
  "aird:validUntil": "2027-01-05"
}
팩 전체를 한 RDF 그래프로
팩의 JSON-LD 파일(마니페스트 · 컬럼 정의서 · 운용 파일 · 확인 지점 판정)을 하나의 RDF 그래프로 합치면 파일 경계를 넘는 참조가 드러납니다. 파일별 구성은 팩 구성과 배포 — 준비 상태별 필요한 파일에 있습니다.
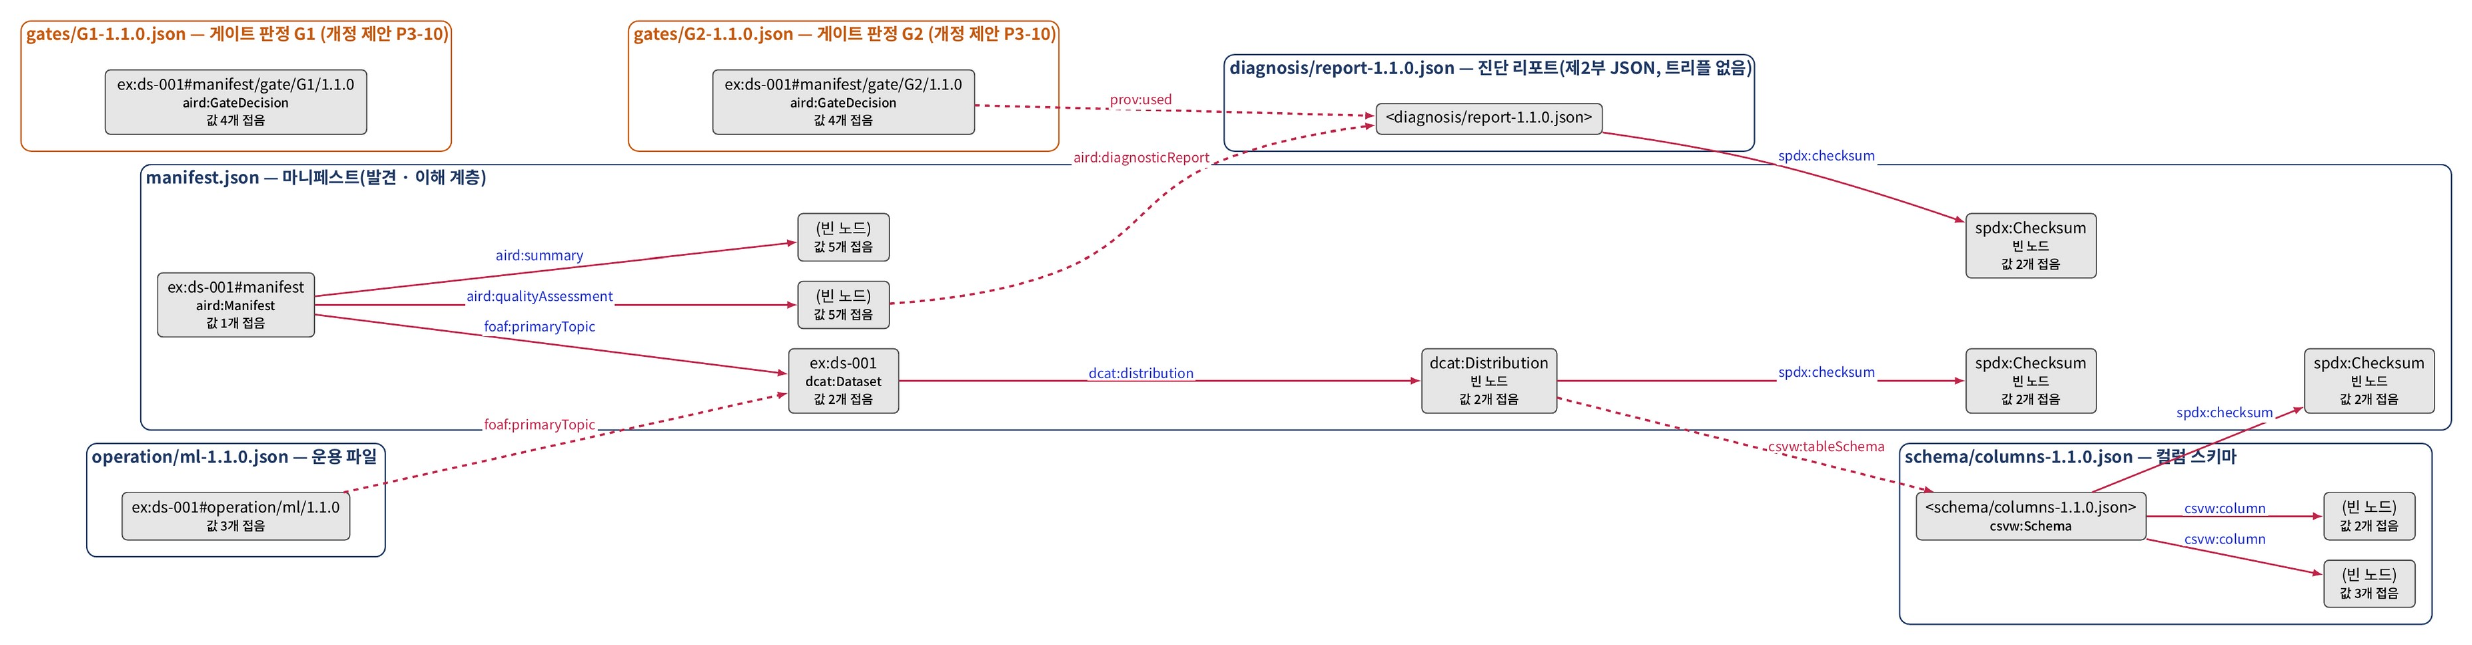
판독 방법은 판단별 필드와 처리, 속성 목록은 기재 항목에 있습니다.
근거: 제2부 부록 Ⅰ · AIRD 어휘표 v0.10.5 2.3.1
공개 도구
AI 레디 데이터 표준 초안을 적용하는 도구 가운데 지금 공개 저장소에서 내려받거나 연결해 쓸 수 있는 도구는 공공데이터 렌즈(MCP 서버)와 카탈로그 변환기 2종입니다. 개발 중인 도구의 상태는 현재 상태와 공개 계획에 있습니다.
공공데이터 렌즈 (public-data-lens)
공공데이터 렌즈는 표준 초안을 공공데이터포털 목록 메타데이터에 적용한 MCP 서버입니다. 에이전트가 활용 목적을 질의하면 서버가 관련 데이터를 검색하고, 목록 메타데이터의 완전성 · 최신성 판정과 카탈로그 수준의 최소 측정 지표(MMI) 측정 결과를 판정 근거와 함께 반환합니다. 이 판정은 데이터 자체의 품질 측정이나 등급 판정이 아닙니다.
| 항목 | 내용 |
|---|---|
| 종류 | MCP 서버 |
| 주 이용자 | 에이전트·AI 개발자 (데이터 이용자) |
| 상태 | 베타 (v1.1) |
| 기능 | 검색 · 단건 조회 · 비교 · 월별 변경 추적 · 카탈로그 통계 · 파일 데이터의 컬럼 구조 · 예시값 관측 · 활용 계획 초안 조립 |
| 판정과 해석 | 판정: 버전 관리 규칙에 따른 서버 수행(재현 가능) · 목적별 해석: 에이전트 수행 |
| 데이터 | 공공데이터포털 전체 목록 월간 스냅샷 (필요성과 사례의 관측은 파일데이터 목록만 대상) — 2026-07 스냅샷 96,110건 (2026-10-05 확인) |
| 한계 | 목록 메타데이터 기반. 실제 데이터의 내용 · 품질 · 결합 가능성 보증 없음 |
| 저장소 | github.com/hike-lab/public-data-lens · MIT |
| 관련 페이지 | 판단별 필드와 처리 · 기재 항목 |
카탈로그 변환기 (aird-tools · catalog-converter)
카탈로그 변환기는 표준을 개발하면서 공개한 구현 도구 모음(aird-tools) 가운데 지금 사용할 수 있는 도구로, 카탈로그 메타데이터를 표준의 기재 형식으로 변환합니다.
| 항목 | 내용 |
|---|---|
| 종류 | 변환 도구 |
| 주 이용자 | 데이터 제공 담당자 |
| 상태 | v0.1 |
| 기능 | 카탈로그 메타데이터 변환 |
| 판정과 해석 | 판정하지 않음 (형식 변환만 수행). 사용법과 입력 형식은 저장소 설명에 있습니다 |
| 한계 | 초기 버전. 데이터 설명서(마니페스트) 검증기 · 품질 평가기 · 변환 파이프라인은 검토 중(현재 상태와 공개 계획) |
| 저장소 | github.com/hike-lab/aird-tools · MIT |
| 관련 페이지 | 기재 항목 |
도구 정보는 2026-10-05에 확인했습니다.
자주 묻는 질문
목차
목차표준의 의무 여부, 작업 범위, 체크섬, 등급 판정 등 자주 묻는 질문에 답합니다. 이 표준은 의무가 아니며, 1단계는 도구 없이 시작할 수 있고, 품질 등급은 운영 지침을 적용해야 판정합니다.
- 의무입니까
- 법령이나 규정에 따른 의무는 아닙니다. 기관 · 기업은 데이터 관리 지침, 사업 요구사항, 계약 조건에서 이 표준을 관련 표준으로 인용해 활용할 수 있습니다. 1단계만 수행해도 에이전트가 추정해야 하는 항목이 줄어듭니다.
- 무엇을 얻습니까
- 에이전트와 이용자가 담당자에게 문의하지 않고 데이터의 목적 적합성, 신뢰성, 다른 데이터와의 결합 가능성, 이용 조건을 판단할 수 있습니다. 에이전트가 데이터를 검색 결과와 결합 후보로 선택하는 근거도 마니페스트에 기재됩니다.
- 어디까지 해야 합니까
- 1단계만 수행해도 발견 계층이 갖춰지므로, 이용자와 에이전트가 데이터를 검색하고 이용 여부를 판단할 수 있습니다. 우선순위는 활용 요청이 있는 데이터 → 다른 데이터와 결합해 쓰는 데이터 → 나머지 데이터 순으로 결정할 것을 권장합니다.
- 데이터를 고쳐야 합니까
- 1단계는 데이터값을 바꾸지 않고 설명을 기재하는 작업입니다. 값의 수정은 2단계 결함 수정에서 하며, 원본을 보존하고 정제본을 따로 만듭니다.
- 얼마나 걸립니까
- 소요 시간은 기존 등록 정보와 컬럼 설명이 갖춰진 정도에 따라 달라집니다. 공개 도구의 카탈로그 변환기로 기존 목록 메타데이터의 일부 항목을 변환할 수 있으므로, 등록 정보에 없는 항목만 직접 기재합니다.
- 체크섬은 누가 계산합니까
- 담당자가 sha256sum 같은 일반 도구로 파일의 SHA-256 체크섬을 계산합니다. 진단 도구를 쓰면 진단 도구가 계산합니다.
- 시스템을 바꿔야 합니까
- 기존 등록 시스템과 내보내기 기능을 먼저 활용합니다. 기존 시스템이 필수 속성 입력 · 버전 관리 · 체크섬 생성 · 데이터 설명서(마니페스트) 발행을 지원하지 않으면 추가 기능을 도입합니다.
- 도구 없이도 할 수 있습니까
- 1단계는 수작업으로 할 수 있고, 2단계의 지표 측정은 진단 도구가 수행합니다. 진단 도구의 배포 계획은 현재 상태와 공개 계획, 결과서를 읽는 방법은 품질 측정과 결과서 — 결과서 읽기에 있습니다.
- 개인정보가 있으면 어떻게 합니까
- 단독으로 판단하지 않고 개인정보 보호 담당 부서와 함께 확인합니다. 확인 절차는 데이터 확인에 있습니다.
- 이미 공개한 데이터는 다시 해야 합니까
- 처음부터 다시 만들지 않고, 기존 고유 식별자를 유지하면서 빠진 설명을 보완합니다. 컬럼 정의서와 라이선스 표기를 먼저 확인합니다.
- 지금 등급을 받을 수 있습니까
- 등급은 운영 지침을 적용해 판정하며, 측정 완성도(표준 용어: 진단 성숙도, DM)가 DM-2여야 합니다. 표준이 제공하는 운영 지침은 표준 제정 시 공개합니다(2026년 12월 예상). 조직은 자체 운영 지침을 구성 · 공개하고 그 운영 지침으로 등급을 판정할 수 있으며, 등급에는 적용한 운영 지침의 식별자 · 버전을 함께 기재합니다. 운영 지침을 적용하지 않은 결과는 등급을 판정하지 않습니다(판정하지 않음: 운영 지침 미적용). 운영 지침의 구성은 운영 지침 구성에 있습니다.
- 이용자가 문제를 알려오면 어떻게 합니까
- 내용을 확인한 뒤 정제 · 설명 수정 · 갱신 중 필요한 조치를 하고 처리 결과를 기록합니다.
- 결과는 어디에 쓰입니까
- 측정 결과는 다음 4곳에 쓰입니다.
- 데이터를 찾는 사람의 판단
- AI 에이전트의 자동 활용
- 조직 내부의 정비 우선순위
- 운영 지침의 임계 프로파일(판정 기준값)을 검토하는 근거
- 잘못 적으면 불이익이 있습니까
- 표준은 기재 오류에 대한 제재를 규정하지 않습니다. 다만 부정확한 기재는 낮은 점수보다 더 큰 문제입니다. 측정하지 않은 항목을 측정한 것으로 기재하거나 한계를 누락하면 이용자와 에이전트가 데이터를 잘못 판단하므로, 확인하지 못한 사항은 「미확인」 또는 「미측정」으로 기재합니다.
- 제4 · 5부의 지위는 무엇입니까
- 제4부(변환 파이프라인·거버넌스)와 제5부(탐색·교환·활용)는 2026년 12월 제정 범위(제1~3부)에 포함되지 않으며, 2027년 중 제정 예정인 후속 부입니다. 이 사이트는 해당 인용에 「후속 부」 표지를 붙입니다.
사이트 소개
이 사이트는 TTA 「AI 레디 데이터」 제1~3부(TTAK 초안 · 0.95 버전)를 해설하고 후속 부(제4·5부)의 구성과 일정을 안내하는 공개 사이트로, 중앙대학교 HIKE 연구실이 운영합니다. 요건은 표준 스펙이 규정하며, 해설과 스펙이 다르면 스펙이 우선합니다.
사이트의 4가지 구성
사이트는 표준의 요건과 판정 방법을 해설하고 적용 가이드·도구·관측 근거를 제공합니다. 내용은 표준, 해설·가이드, 도구, 근거의 4개 층으로 구성됩니다.
층별 내용과 사이트 내 위치
사이트의 메뉴
메뉴는 표준 소개, 데이터 준비, 에이전트 활용, 운영 지침, 개념과 판정, 찾아보기의 6개 갈래입니다.
발행 정보
| 항목 | 내용 |
|---|---|
| 운영 | 중앙대학교 HIKE 연구실 |
| 표준 | AI 레디 데이터 표준 초안 (제1~3부) · 표준 번호 확정 전 |
| 제정 범위 | 2026년 12월 제정 범위는 제1~3부입니다. 제4 · 5부는 2027년 중 제정 예정인 후속 부입니다. |
| 어휘 | AIRD 어휘표 v0.10.5 (기준 어휘) |
| 콘텐츠 이용 조건 | CC BY 4.0 |
| 공개 주소 | https://aird.datahub.kr |
| 오류 신고 | hike.cau@gmail.com |
사이트의 지위
이 사이트의 내용은 법령이나 규정에 따른 의무사항이 아니며, 사이트는 새로운 요건을 만들지 않습니다. 준거 표준은 TTA 「AI 레디 데이터」 제1~3부 표준 초안입니다. 후속 부(제4·5부)는 2027년 중 제정 예정이며, 구성과 일정만 안내합니다. 해설은 공공기관·기업·민간 비영리 단체의 데이터에 모두 적용됩니다. 표준 제정본에서 요건이나 식별자가 변경되면 이 사이트도 함께 갱신합니다.
사이트의 범위
사이트는 확인·기재 항목과 항목별 근거·판단 기준을 제시하고, 오류 사례와 수정 사례, 결과서 해석 방법을 설명합니다. 새로운 의무 부과, 판정 기준 결정(운영 지침 발행 주체가 결정), 특정 조직·데이터셋 평가, 조직 간 순위 산정, 파일을 받아 진단하는 일(진단 도구 배포 버전은 개발 중)은 범위에서 제외합니다.
표준이 만들어진 경과는 표준의 출발과 경과에 있습니다.
이용 통계 수집 안내
이 사이트는 이용 현황을 파악해 내용을 개선하기 위해 Google 애널리틱스 4를 사용합니다. 개인을 식별하는 정보, 검색어, 위젯에 입력하거나 선택한 값은 수집하지 않습니다. 브라우저의 추적 방지 기능이나 Google 애널리틱스 차단 부가 기능을 사용하면 수집되지 않으며, 사이트 이용에는 영향이 없습니다.
수집 항목과 보관 기간
| 항목 | 내용 |
|---|---|
| 수집하는 정보 | 방문한 페이지 주소와 제목 · 머문 시간 · 스크롤 · 외부 링크 이동 · 파일 내려받기 · 영상 재생 · 위젯과 검색의 사용 여부 · 유입 경로 · 대략의 지역(국가 · 도시) · 브라우저와 기기 종류 |
| 수집하지 않는 정보 | 이름 · 이메일 등 개인을 식별하는 정보 · 검색어 · 위젯에 입력하거나 고른 값. Google 애널리틱스 4는 IP 주소를 저장하지 않습니다. |
| 사용하지 않는 기능 | Google 신호 데이터 · 광고 개인 최적화 · 광고 계정 연결 |
| 보관 기간 | 이벤트 데이터 2개월 |
| 수집 거부 | 브라우저의 추적 방지 기능이나 Google 애널리틱스 차단 부가 기능을 사용하면 수집되지 않습니다. 사이트 이용에는 영향이 없습니다. |
소개 자료
기사·발표·보고서에 그대로 인용할 수 있는 소개문·핵심 사실·그림입니다. 이용 조건은 CC BY 4.0이며, 출처는 「AI 레디 데이터 해설(aird.datahub.kr), 중앙대학교 HIKE 연구실」로 기재합니다.
한 문장 소개
AI 레디 데이터(AIRD) 표준 초안은 AI 에이전트가 데이터를 추정하지 않고 판단하도록, 데이터에 관한 사실을 기계가 읽는 형식으로 기록하고 그 준비 상태를 판정하는 방법을 규정합니다.
3문장 소개
AI 레디 데이터(AIRD) 표준 초안은 AI 에이전트가 데이터를 추정하지 않고 판단하도록, 데이터에 관한 사실을 기계가 읽는 형식으로 기록하고 그 준비 상태를 판정하는 방법을 규정합니다. 데이터 제공자는 데이터 파일과 함께 데이터 설명서(마니페스트)를 제공하고, 품질을 7개 차원·16개 지표로 측정해 결과서로 남깁니다. 데이터는 찾을 수 있는 데이터(Discoverable)·품질이 확인된 데이터(Quality-Ready)·목적에 맞게 준비된 데이터(Purpose-Ready)로 판정되며, AI 레디 데이터는 이 가운데 AI 활용을 위한 공통 준비 요건을 충족한 Quality-Ready 또는 Purpose-Ready 상태의 데이터입니다.
한 문단 소개
AI 에이전트는 데이터에 적히지 않은 단위·기준 시점·이용 조건을 추정하고, 틀린 결론도 오류 없이 실행합니다. AI 레디 데이터(AIRD) 표준 초안은 이 문제를 다룹니다. 표준 초안은 데이터에 관한 사실을 기록하고, 품질을 측정하고, 준비 상태를 판정하고, 그 근거로 데이터를 활용하는 4개 활동의 방법을 규정합니다. 데이터값은 바꾸지 않고 데이터 설명서(마니페스트)와 결과서를 함께 제공하며, 판정 기준값은 표준과 별도의 운영 지침이 설정합니다. 공공기관·기업·민간 비영리 단체의 데이터에 같은 절차를 적용하며, 법령에 따른 의무는 아닙니다. 제1~5부는 2026년 5월 13일 TTA에 표준으로 제안되어 심의 중이며, 이 가운데 제1~3부는 2026년 12월, 제4·5부는 2027년 중 제정을 예상합니다. 해설 사이트는 중앙대학교 HIKE 연구실이 운영합니다.
핵심 사실
| 항목 | 내용 |
|---|---|
| 표준 | TTA 「AI 레디 데이터」 제1~3부 TTAK 초안(0.95 버전) · 제4 · 5부는 후속 부(2027년 중 제정 예정) |
| 일정 | 2026-03-09 작성 시작 · 2026-05-13 TTA 제안 · 2026년 12월 제정 예상 |
| 4가지 판단 | 적합성 · 신뢰성 · 결합성 · 사용 가능성 |
| 4개 활동 | 기록 · 측정 · 판정 · 활용 |
| 준비 상태 | Discoverable → Quality-Ready → Purpose-Ready (AI 레디 데이터는 Quality-Ready 또는 Purpose-Ready) · 효력 정지(Stale) |
| 측정 | 품질 7개 차원 · 16개 지표 |
| 기재 항목 | 발견 계층 필수 23개 (AIRD 어휘표 v0.10.5 데모 프로파일) |
| 범위 | 데이터 유형 5종(표 형태, 시계열, 문서, 이미지, 지시문·응답 쌍) · 활용 목적 6종 |
| 적용 대상 | 공공 · 기업 · 민간 비영리 데이터 — 어디에 적용하나 |
그림
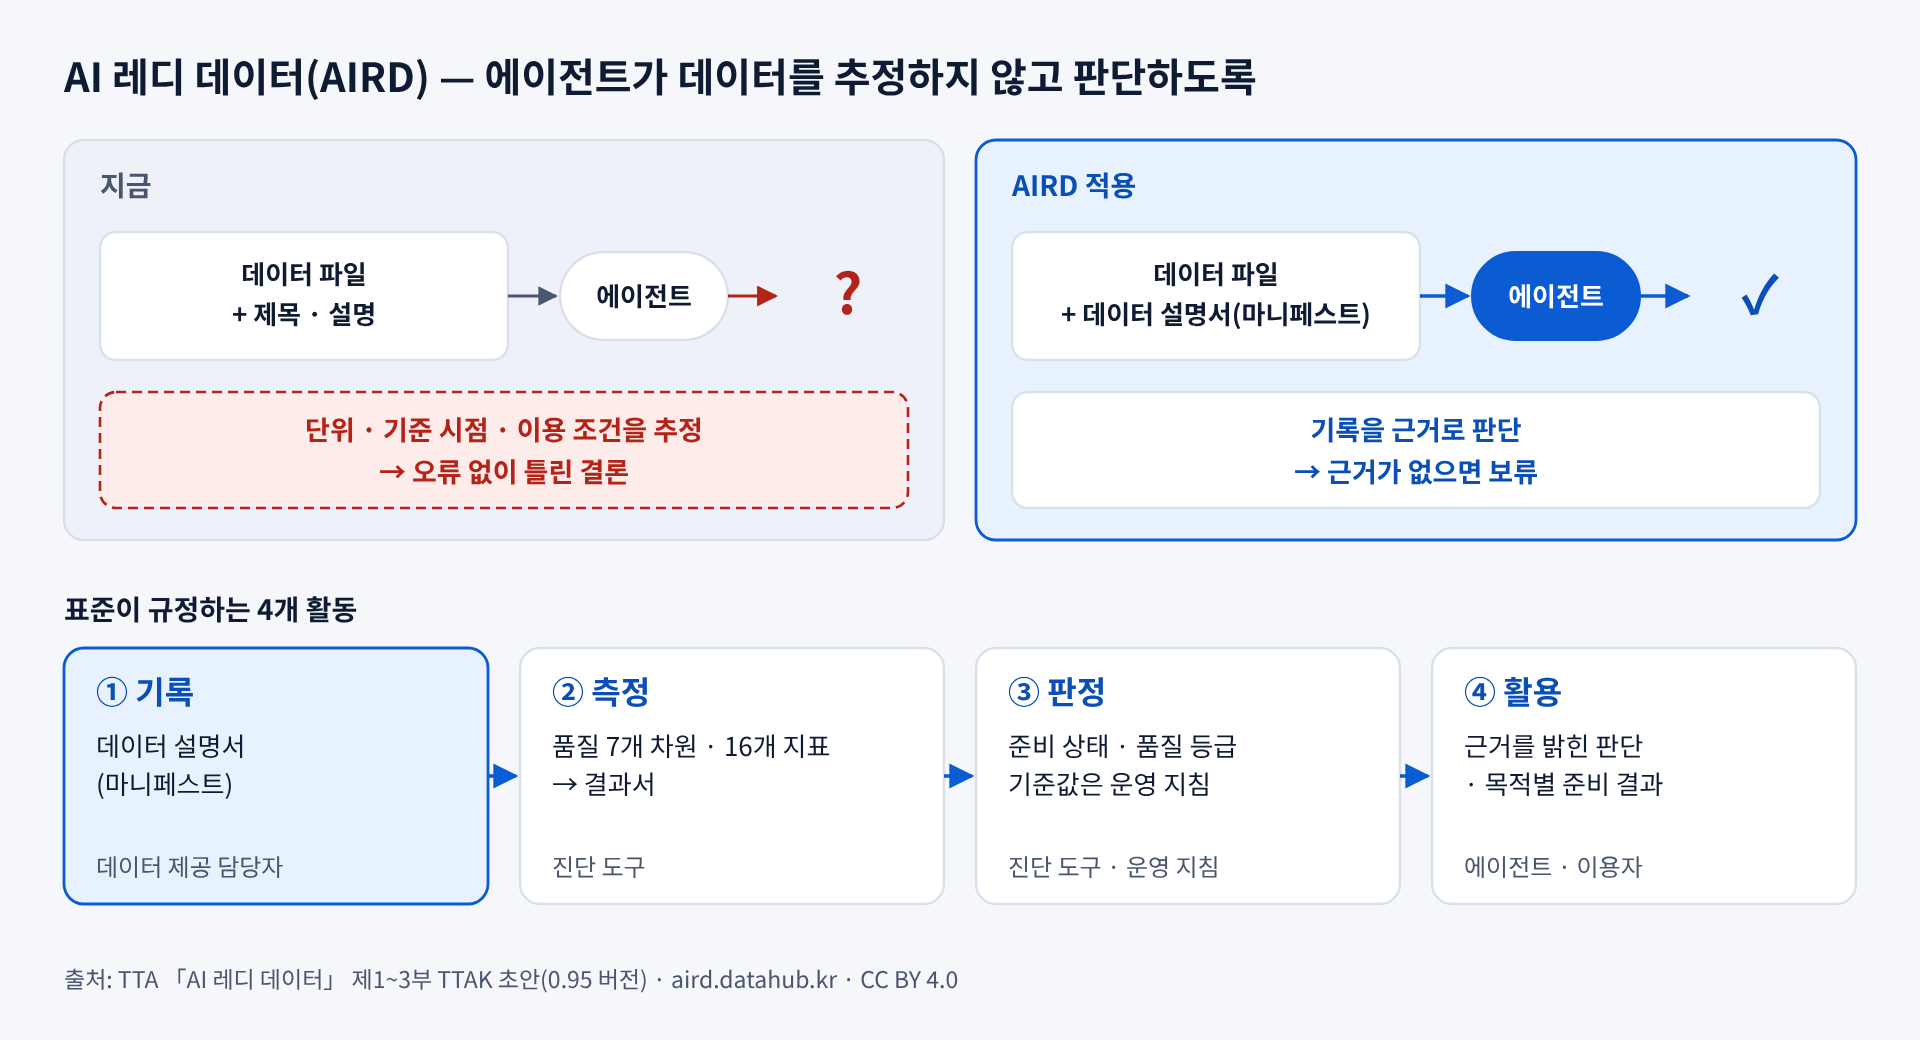
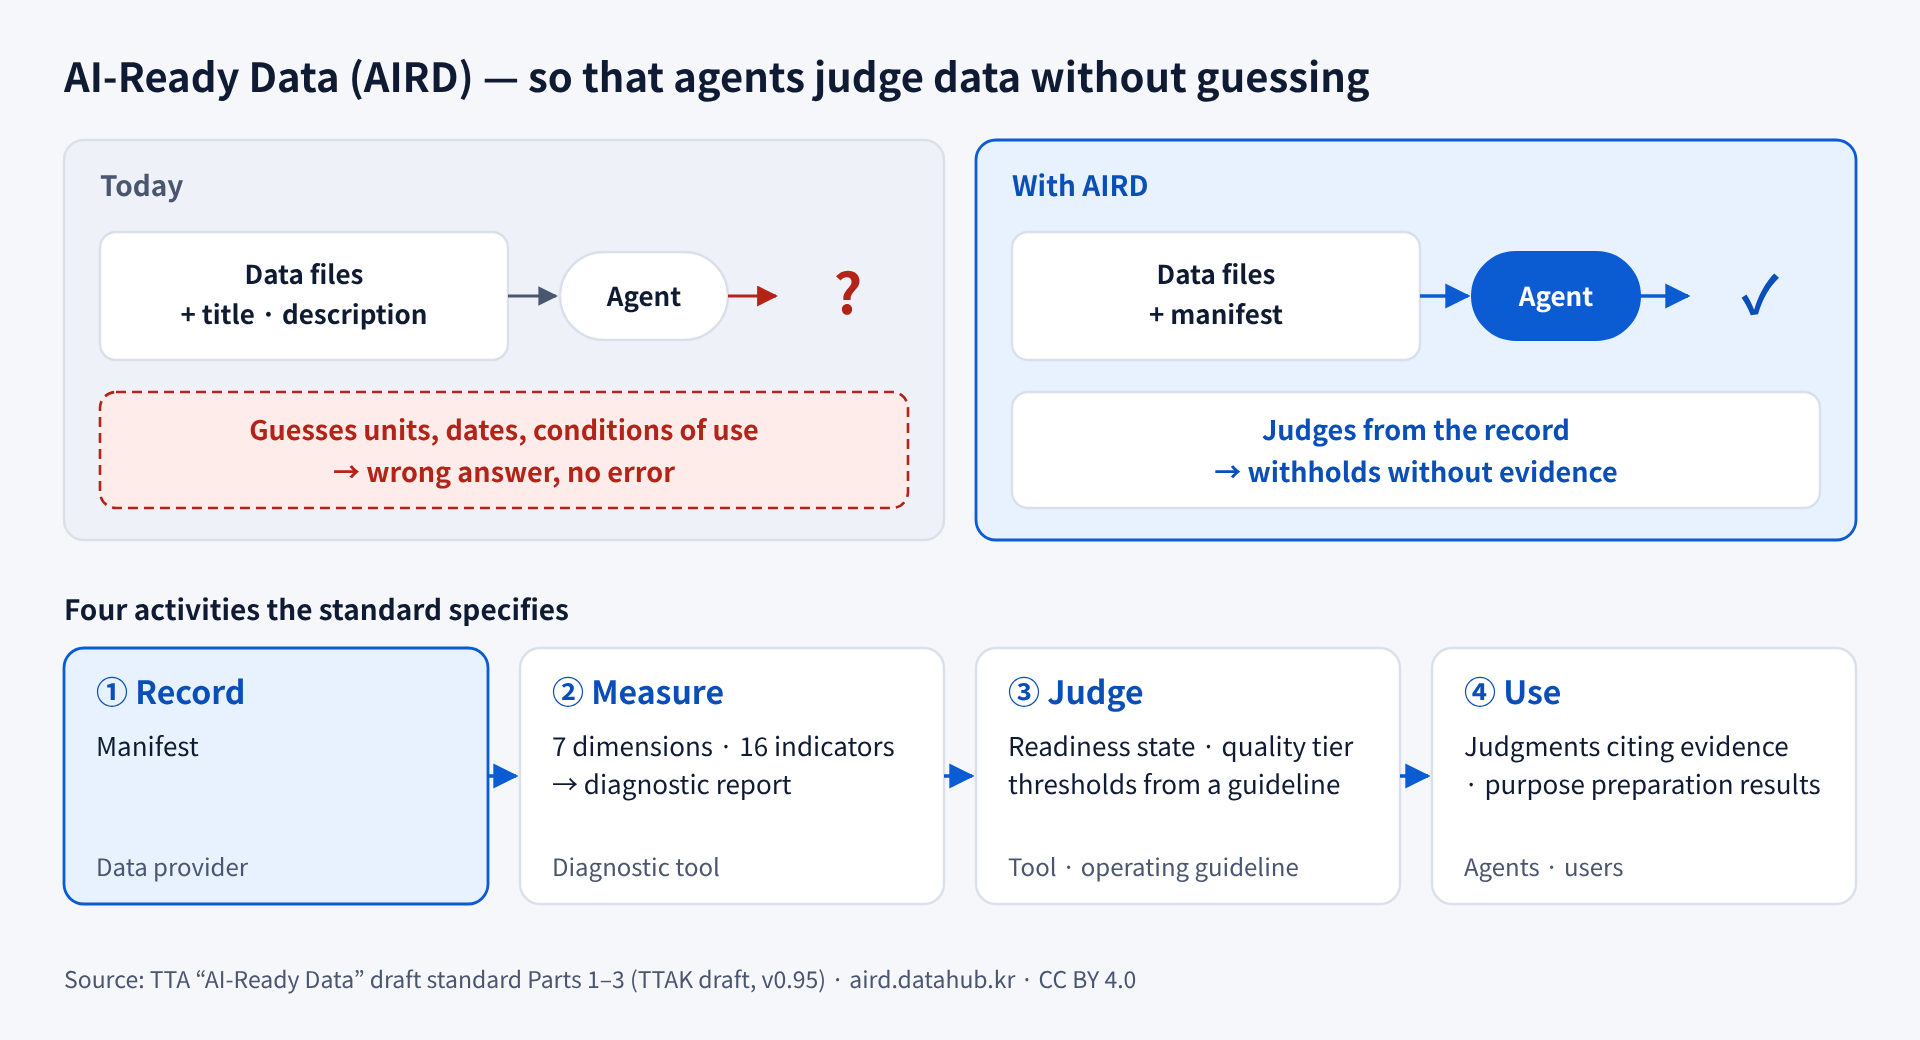
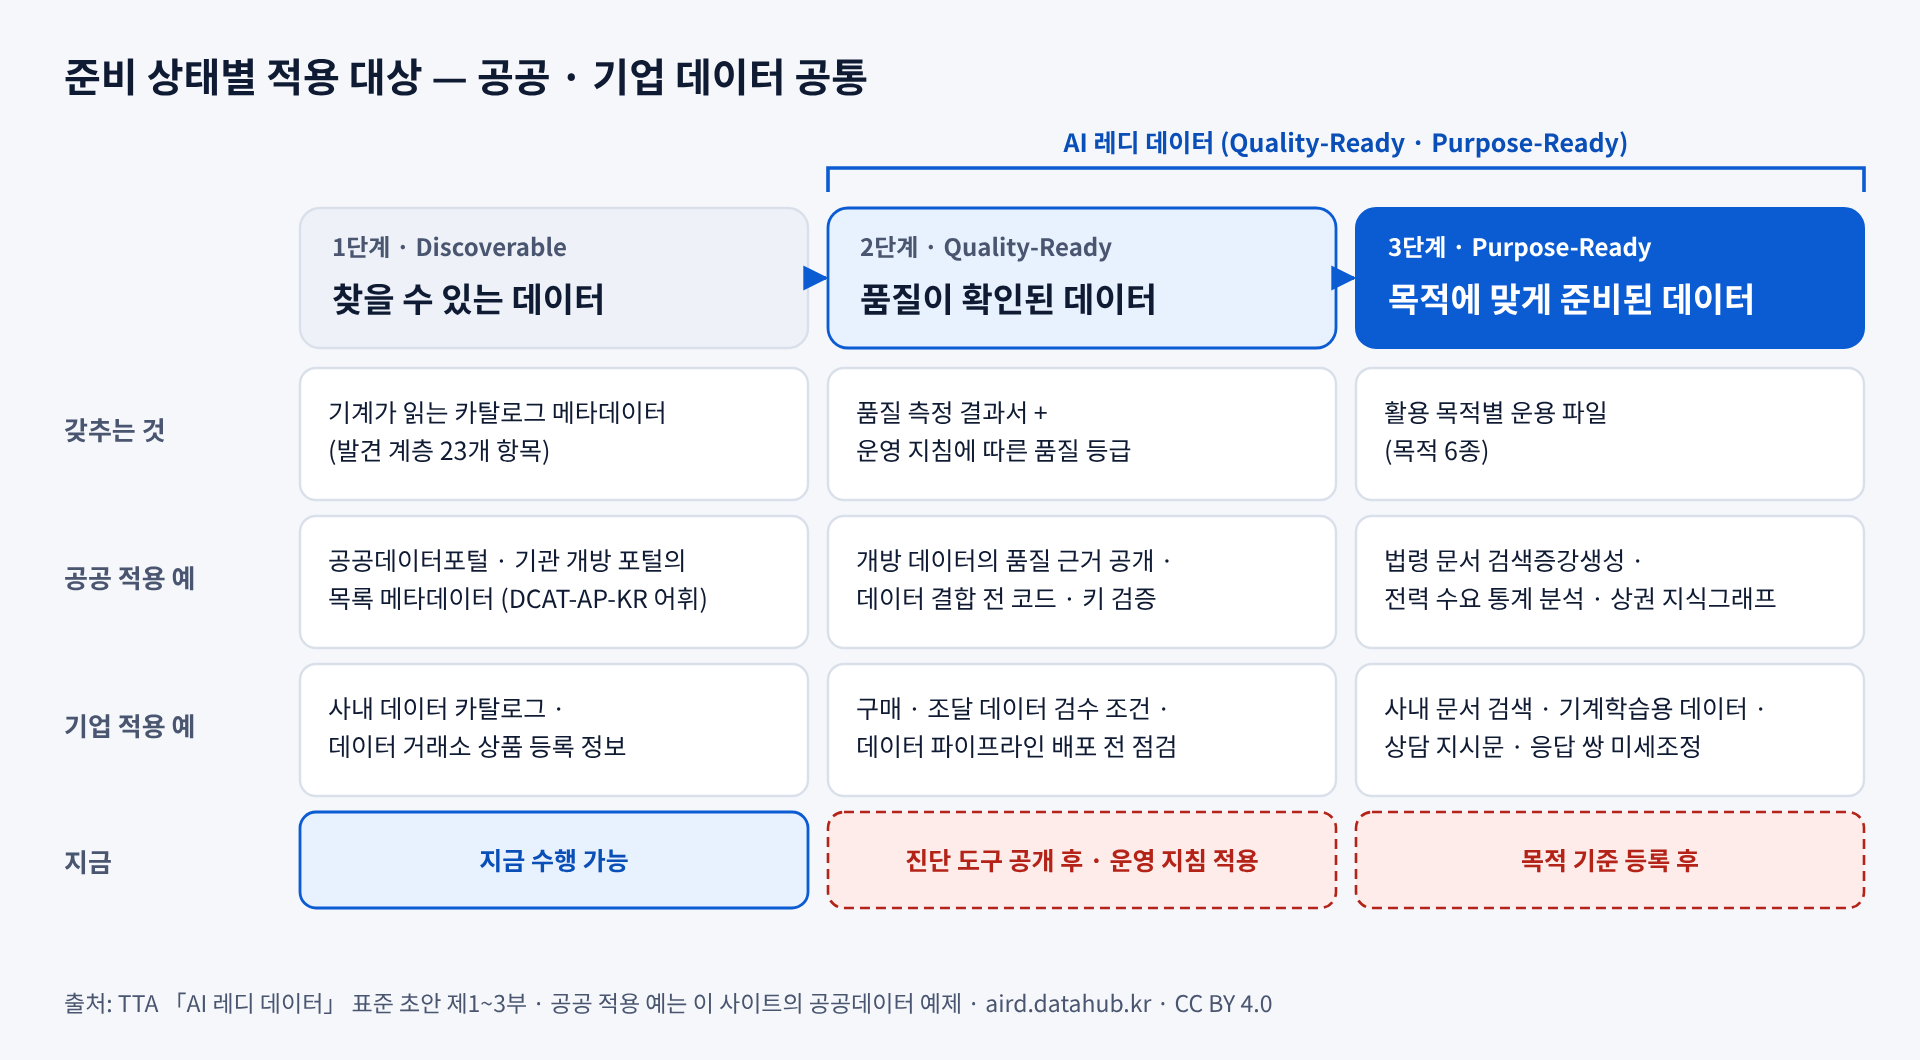
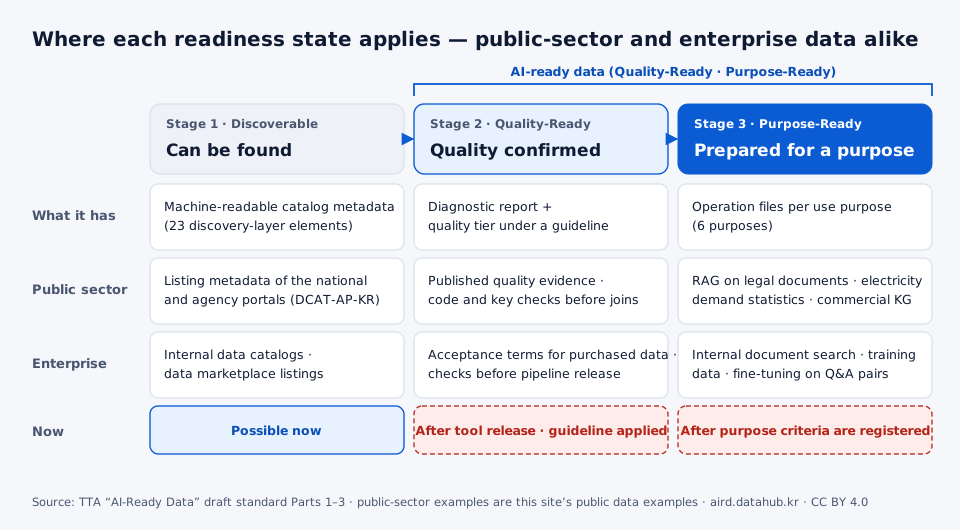
표기 안내
| 권장 표기 | 피할 표기 | 이유 |
|---|---|---|
| AI 레디 데이터(AIRD) · 영문 AI-Ready Data | AI 준비 데이터 · AI용 데이터 | 표준 명칭 |
| 표준 초안 · 2026년 12월 제정 예상 | 국가 표준 · 제정된 표준 | 심의 중 |
| 품질 등급은 운영 지침을 적용해 판정 | AIRD 인증 · AIRD 등급 획득 | 표준 제공 운영 지침은 제정 시 공개 · 인증 제도는 표준의 범위 밖 |
| 측정 엔진(시험용)으로 계산한 값 | 정확도가 높아진다 | 실제 에이전트 효과는 아직 측정하지 않음 |
| 조직이 인용해 활용 | 의무 적용 | 법령에 따른 의무가 아님 |